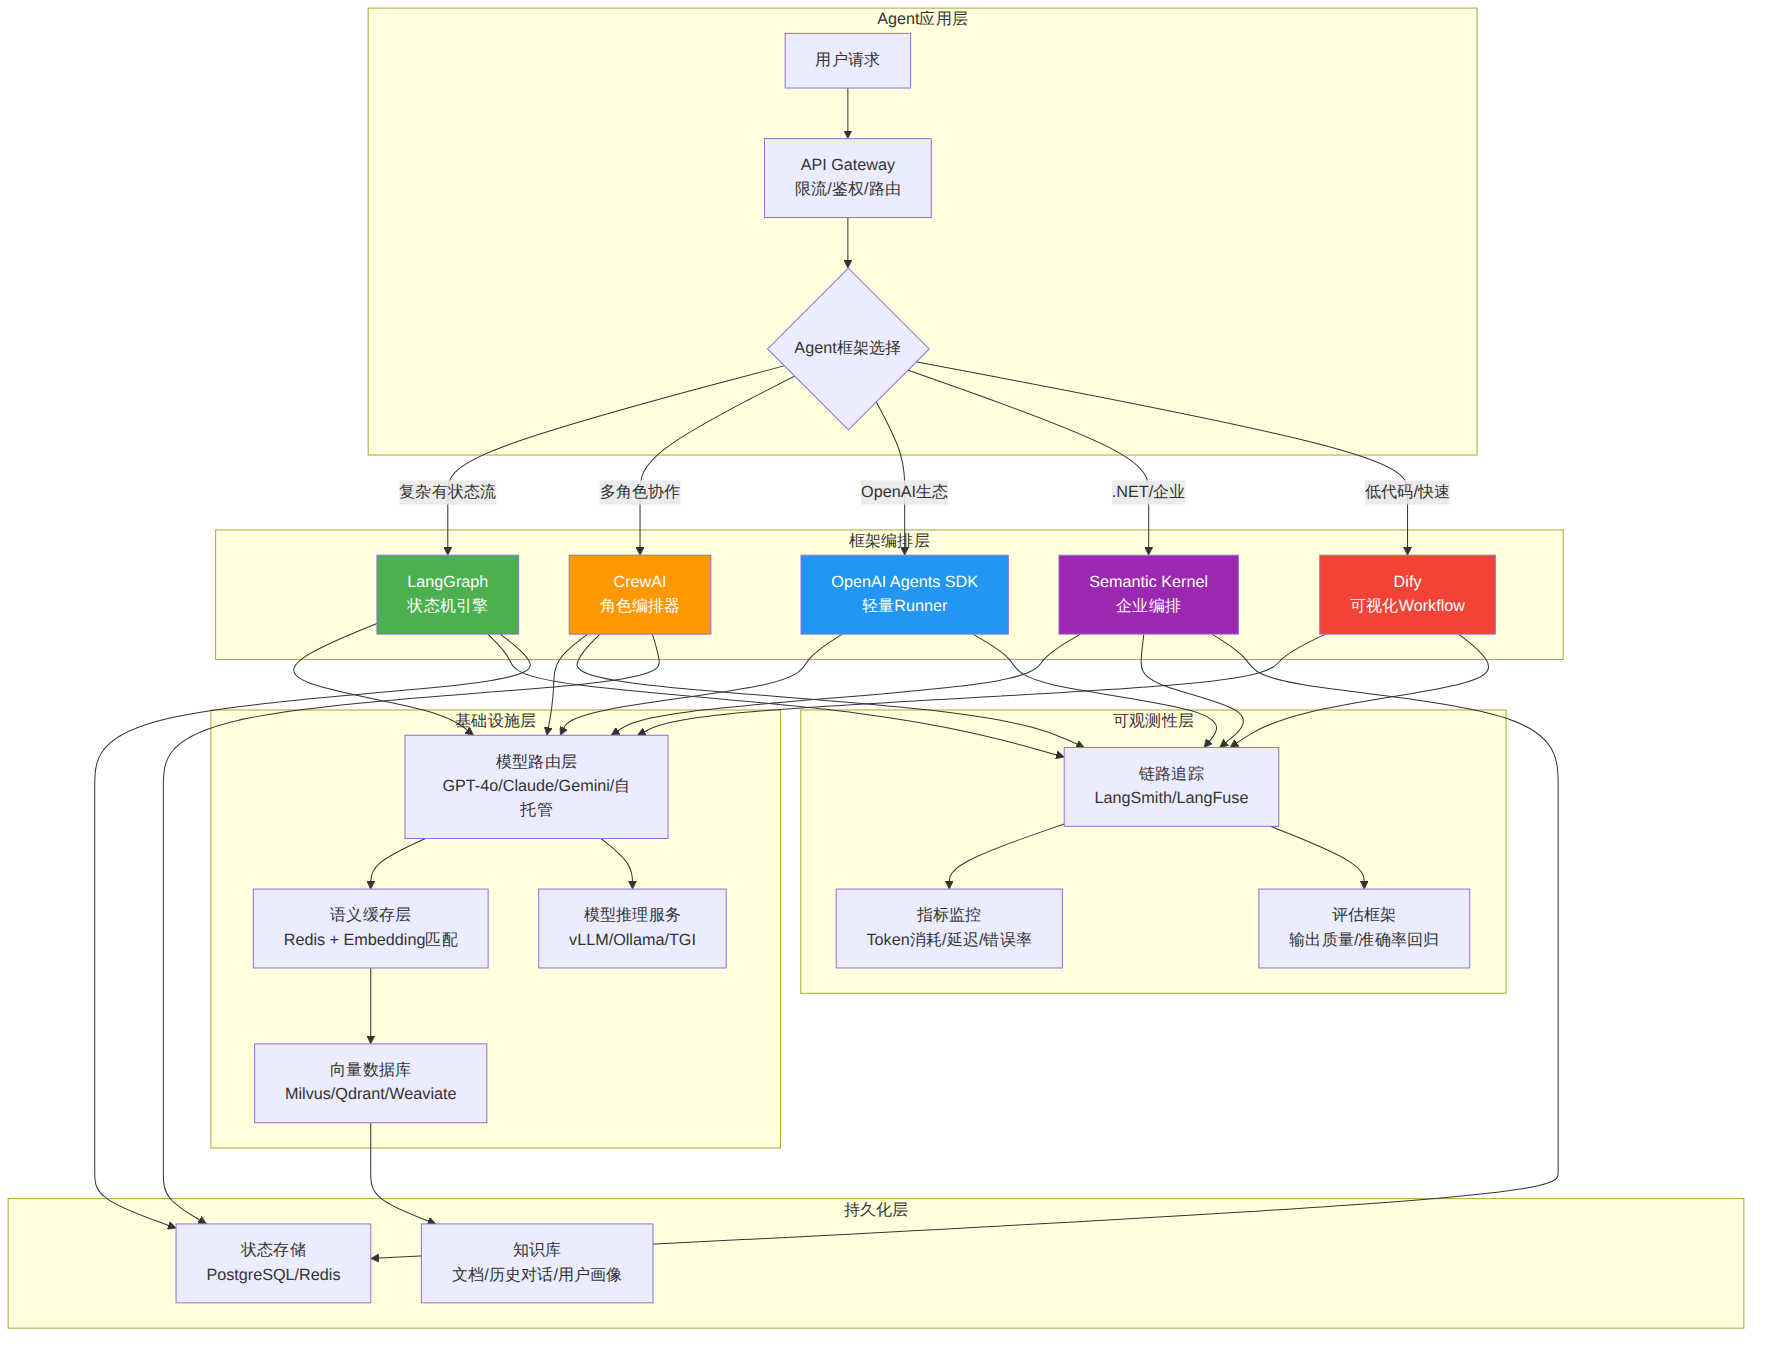
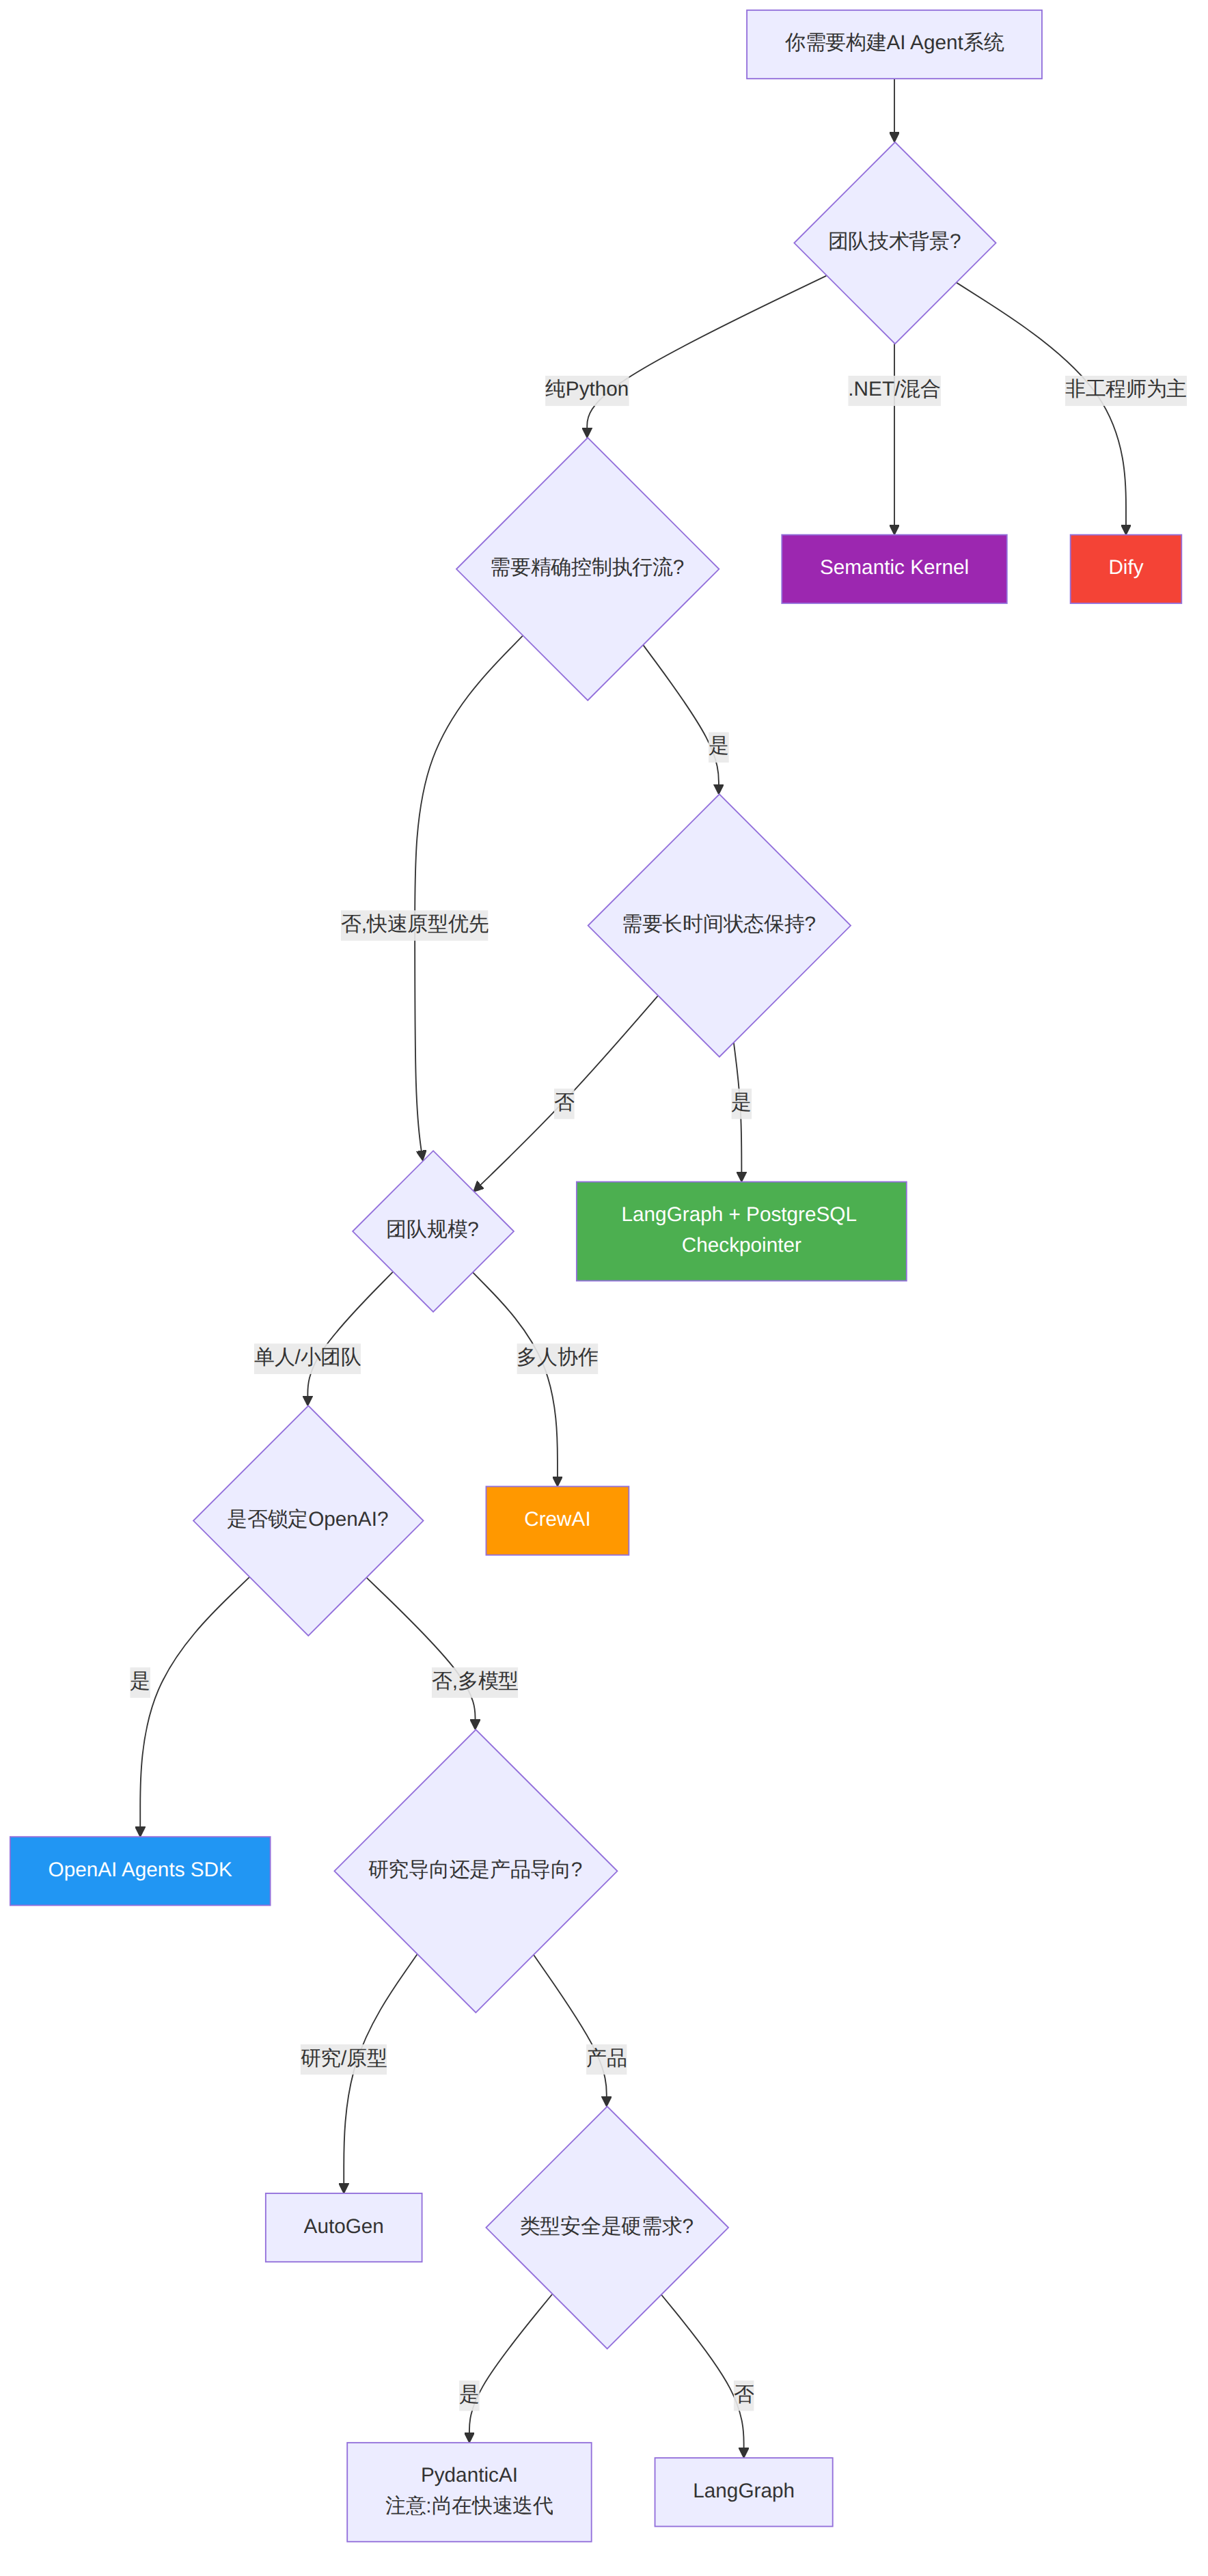
2026年Q2,全球54%的企业已将AI Agent投入生产环境,但"Demo到生产"之间的鸿沟依然巨大。本文从工程实践视角,对LangGraph、CrewAI、AutoGen、OpenAI Agents SDK、Semantic Kernel、Dify、PydanticAI七大框架进行横评,聚焦真实部署案例中的架构选型、成本优化、延迟治理和踩坑经验。文章不再重复"Hello World"级别的快速上手,而是直击每个框架在生产环境中暴露的工程瓶颈与解法。
| 维度 | LangGraph | CrewAI | AutoGen (AG2) | OpenAI Agents SDK | Semantic Kernel | Dify | PydanticAI |
|---|---|---|---|---|---|---|---|
| 核心架构 | 有向图状态机 | 角色协作模型 | 多Agent对话式 | 轻量Runner模型 | 企业编排引擎 | 低代码平台 | 类型安全Runner |
| GitHub Stars | ~18K | ~25K | ~42K | ~15K | ~22K | ~65K | ~8K |
| 生产就绪度 | ★★★★★ | ★★★★ | ★★★ | ★★★★ | ★★★★★ | ★★★★ | ★★★ |
| 状态持久化 | 内置Checkpoint | Redis+向量库 | 有限支持 | 无内置 | 多后端适配 | 内置 | 无 |
| 可观测性 | LangSmith原生 | LangFuse/第三方 | LangFuse/手动 | LangSmith | Azure Monitor | 内置Trace | LangFuse |
| 上手时间 | 2-3天 | 半天 | 1-2天 | 2-3小时 | 3-5天 | 1-2小时 | 1天 |
| 成本控制 | 模型路由+缓存 | Token限制器 | 手动管理 | 内置Guardrails | 企业级管控 | 内置Token计费 | 手动 |
| 适用场景 | 复杂有状态工作流 | 快速多角色原型 | 研究/对话式 | OpenAI生态集成 | 大型企业集成 | 快速应用搭建 | 类型安全需求 |
| 变现潜力 | 高(训练营+企业咨询) | 高(垂直解决方案) | 中(学术培训) | 中(OpenAI生态课) | 高(企业培训) | 极高(SaaS/训练营) | 中(技术课程) |
LangGraph是2026年生产部署率最高的Agent框架。其核心设计理念是将Agent行为建模为有向图状态机——每个节点是一个处理步骤,边定义条件转移,整个图支持循环、分支和并行执行。
生产案例:某保险集团AI销售训练系统
47Billion团队为全球保险公司构建的AI销售训练Agent,基于LangGraph的核心原因有三:
# LangGraph核心:带状态检查点的有向图
from langgraph.graph import StateGraph, END
from langgraph.checkpoint.postgres import PostgresSaver

graph = StateGraph(AgentState)
graph.add_node("assess_risk", assess_risk_node)
graph.add_node("generate_quote", generate_quote_node)
graph.add_node("human_review", human_review_node)

graph.add_conditional_edges("assess_risk", route_by_risk, {
    "high": "human_review",
    "low": "generate_quote",
})
graph.add_edge("human_review", "generate_quote")
graph.add_edge("generate_quote", END)

# 生产环境关键:PostgreSQL持久化检查点
checkpointer = PostgresSaver.from_conn_string(DB_URI)
app = graph.compile(
    checkpointer=checkpointer,
    interrupt_before=["human_review"]  # 审批前暂停
)
工程踩坑:LangGraph的学习曲线是七大框架中最陡的。理解图的节点-边-状态三要素并不难,但生产环境中需要处理状态序列化失败、检查点膨胀(一个长期运行的图可能产生数千个检查点)、以及图版本升级时的状态迁移问题。团队通常需要2-3周才能真正将LangGraph投入生产,远超"30分钟上手"的宣传。
成本治理:某电商公司部署LangGraph客服Agent后发现,单次会话平均消耗12K tokens。通过引入语义缓存(对相似问题复用前5轮对话的缓存结果)和模型路由(简单问题路由到GPT-4o-mini,复杂问题才用GPT-4o),将月度API成本从$8,200降至$3,100。
CrewAI以"角色扮演式多Agent协作"闻名——你定义几个Agent(研究员、编辑、审核员),给每个Agent分配工具和目标,它们自动协作完成任务。这种抽象层次在概念上极其直观,但生产环境中暴露出明显的架构短板。
生产案例:某媒体公司自动化内容生产线
一家数字媒体公司使用CrewAI构建了"研究员+编辑+SEO优化师+审核员"四Agent内容生产流水线。从概念验证到可运行原型只花了3天,但从原型到稳定生产又花了5周。
核心问题出在Agent间的失控对话。CrewAI的默认协作模式是"顺序执行"和"层级委派",但在生产环境中,Agent可能陷入无限循环——研究员不断要求编辑修改,编辑又要求研究员补充材料。团队最终不得不在每个Agent节点添加最大迭代次数限制和输出格式校验。
# CrewAI生产级配置:关键在于限制Agent行为
from crewai import Agent, Task, Crew, Process

researcher = Agent(
    role="市场研究员",
    goal="深度分析行业趋势并生成结构化报告",
    backstory="你是一名有10年经验的市场分析师",
    llm=llm,
    max_iter=5,           # 关键:限制迭代次数
    memory=True,
    verbose=True,
)

# 生产级Task必须定义明确的输出格式
research_task = Task(
    description="分析{topic}的市场现状",
    agent=researcher,
    expected_output="包含3个核心发现的结构化JSON报告",
    output_json=True,     # 强制JSON输出
    callback=validate_output,  # 输出校验回调
)

crew = Crew(
    agents=[researcher, writer, reviewer],
    tasks=[research_task, write_task, review_task],
    process=Process.sequential,
    max_rpm=30,           # 限流:每分钟最多30次请求
    full_output=True,
)
CrewAI Enterprise的进阶能力:2026年CrewAI Enterprise版本新增了Knowledge管理(内置向量检索)、内置评估框架和部署工具。但对于需要精确控制执行流的场景(如金融交易、医疗诊断),CrewAI的"高层抽象"反而成为瓶颈——你无法像LangGraph那样精确控制每一步的状态转换和错误恢复。
变现评估:CrewAI是最适合包装成"AI Agent训练营"的框架。半天上手、可视化团队协作、概念直观——这些特点使其成为教育培训的绝佳素材。市场上已有多个$499-$999的CrewAI实战课程。
AutoGen在2025年底从微软研究院迁移到社区驱动的AG2项目,GitHub星标数仍居三甲(~42K),但生产部署率明显低于LangGraph和CrewAI。
核心架构差异:AutoGen围绕"对话式多Agent交互"设计——多个Agent通过消息传递进行协作,每个Agent维护自己的对话历史。这种设计在研究场景中极其灵活,但在生产环境中带来了三个具体问题:
# AutoGen多Agent对话:简洁但生产化需要大量包装
import autogen

researcher = autogen.AssistantAgent(
    name="researcher",
    system_message="你是一名数据分析师",
    llm_config=llm_config,
    max_consecutive_auto_reply=3,  # 防止无限对话
)

coder = autogen.AssistantAgent(
    name="coder",
    system_message="你是一名Python开发专家",
    llm_config=llm_config,
)

user_proxy = autogen.UserProxyAgent(
    name="user",
    human_input_mode="NEVER",
    max_consecutive_auto_reply=0,
    code_execution_config={"use_docker": True},  # 沙箱执行
)

# 群聊编排
groupchat = autogen.GroupChat(
    agents=[user_proxy, researcher, coder],
    messages=[],
    max_round=15,  # 关键:限制总轮次
)
manager = autogen.GroupChatManager(groupchat=groupchat)
user_proxy.initiate_chat(manager, message="分析这份数据")
最佳适用场景:AutoGen在"代码生成+数据分析"场景中仍然表现优异。微软内部团队和多家研究机构使用AutoGen构建内部工具——代码审查、数据Pipeline自动化、文档生成等。但如果你的Agent需要与外部系统深度集成(ERP、CRM、数据库),LangGraph或Semantic Kernel是更安全的选择。
2026年初,OpenAI正式发布Agents SDK(取代早期的Swarm实验项目),定位为"轻量级、OpenAI原生"的Agent开发工具包。其核心设计哲学是极简:用最少的抽象构建可靠的Agent。
架构亮点:Agents SDK的三个核心原语——Agent、Handoff(Agent间任务移交)、Guardrail(输入/输出护栏)——构成了一个精简但有效的生产框架。Guardrail机制尤其值得称道:你可以在Agent接收输入和生成输出时各设置一道护栏,自动过滤敏感信息、验证输出格式。
# OpenAI Agents SDK:Guardrail是生产环境的关键防线
from agents import Agent, Runner, GuardrailFunctionOutput
from agents import input_guardrail, output_guardrail

@input_guardrail
async def check_sensitive_info(ctx, agent, input):
    """防止用户输入敏感信息(如SSN、信用卡号)"""
    result = await scan_for_pii(input)
    return GuardrailFunctionOutput(
        output_info={"pii_found": result.found},
        tripwire_triggered=result.found,
    )

@output_guardrail
async def validate_json_output(ctx, agent, output):
    """确保输出符合预期JSON Schema"""
    try:
        json.loads(output)
        return GuardrailFunctionOutput(
            output_info={"valid": True},
            tripwire_triggered=False,
        )
    except:
        return GuardrailFunctionOutput(
            output_info={"valid": False},
            tripwire_triggered=True,
        )

agent = Agent(
    name="customer_support",
    instructions="处理客户咨询",
    input_guardrails=[check_sensitive_info],
    output_guardrails=[validate_json_output],
)
生产限制:Agents SDK的最大短板是供应商锁定——它紧密耦合OpenAI的API。如果你想同时使用Claude或Gemini作为后备模型,需要额外的适配层。此外,缺乏内置的状态持久化和检查点机制意味着你需要自建这些能力。
工程实战评估:如果你的技术栈已经深度绑定OpenAI生态(使用Assistants API、GPT-4o、DALL-E等),Agents SDK是最快的生产路径。2-3小时就能搭建一个带护栏、能Handoff的生产级Agent。但对于需要多模型混合或自托管推理的场景,这不是最优选择。
微软Semantic Kernel是七大框架中"企业级"属性最强的。它原生支持C#和Python双语言,深度集成Azure生态(Azure OpenAI、Azure AI Search、Azure Monitor),专为大型企业的IT治理需求设计。
生产案例:某制造业集团的智能运维系统
一家跨国制造企业使用Semantic Kernel构建了覆盖20个工厂的智能运维Agent系统。选择Semantic Kernel的核心原因是:该企业已有大量.NET/azure技术栈投资,Semantic Kernel能与现有Azure DevOps Pipeline、Azure Monitor告警、Azure AD权限体系无缝集成。
关键架构决策: - Plugin体系:将每个运维能力(设备监控、工单创建、知识库查询)封装为独立Plugin,支持版本管理和A/B测试 - 内存管道:利用Semantic Kernel的Memory抽象层,将设备手册、历史工单、传感器数据统一索引到Azure AI Search - Telemetry:与Azure Application Insights深度集成,实现Agent调用的全链路追踪
// Semantic Kernel (C#) 企业级Plugin定义
public class DeviceDiagnosticsPlugin {
    [KernelFunction]
    [Description("根据设备ID查询异常诊断建议")]
    public async Task<string> DiagnoseDevice(
        Kernel kernel,
        [Description("设备编号")] string deviceId,
        [Description("异常描述")] string anomaly
    ) {
        var searchResults = await kernel.Memory.SearchAsync(
            "device-manuals", $"{deviceId} {anomaly}", limit: 5
        );
        var context = string.Join("\n", searchResults.Select(r => r.Metadata.Text));

        var prompt = $"基于以下设备手册内容,为设备{deviceId}的异常'{anomaly}'提供诊断建议:\n{context}";
        return await kernel.InvokePromptAsync<string>(prompt);
    }
}
适用场景与局限:Semantic Kernel是传统IT企业将AI Agent纳入既有技术治理体系的最佳选择。但它的学习曲线较长(尤其对纯Python团队),框架抽象层次多,调试链路复杂。对于初创公司或小团队,这往往意味着过度工程化。
Dify在2026年以~65K GitHub Stars领跑所有Agent框架,其成功密码在于:让非工程师也能搭建生产级AI应用。
核心差异化:Dify提供了可视化的Workflow编排界面——通过拖拽节点构建Agent工作流,支持条件分支、循环节点、变量传递、工具调用等。这意味着产品经理、运营人员都能参与Agent的设计和迭代。
生产案例:某在线教育公司的智能答疑系统
一家在线教育平台使用Dify在2周内上线了覆盖10个学科的智能答疑Agent。团队配置:1名后端工程师(负责API对接和部署)+ 2名教育产品经理(负责知识库构建和工作流设计)。最终效果:答疑准确率82%,单次响应延迟<3秒,月度运营成本$1,200。
Dify的技术局限: - 自定义能力受限:当你需要复杂的条件逻辑、自定义工具或深度集成第三方系统时,Dify的可视化界面反而成为限制。你不得不在"低代码"和"全代码"之间反复横跳。 - 性能天花板:Dify的运行时引擎在处理复杂工作流时存在性能瓶颈。一个包含20+节点的复杂工作流,响应延迟可能从2秒飙升至15秒。 - 自托管复杂度:Dify自托管版依赖Docker Compose编排13个服务容器(包括Nginx、PostgreSQL、Redis、Celery、Weaviate等),运维成本不容忽视。
# Dify自托管生产部署的核心挑战:13个容器
# docker-compose.yaml 片段
services:
  api:
    image: langgenius/dify-api:latest
    depends_on: [db, redis, weaviate, sandbox, ssrf_proxy]
  web:
    image: langgenius/dify-web:latest
  db:
    image: postgres:15
  redis:
    image: redis:7
  weaviate:
    image: weaviate:latest
  sandbox:
    image: langgenius/dify-sandbox:latest
  ssrf_proxy:
    image: ubuntu/squid:latest
  # ... 还有6个服务
变现潜力评估:Dify是所有框架中变现路径最宽的。它既适合面向中小企业的"AI应用定制开发"服务,也适合面向技术爱好者的"低代码AI训练营"。市场上已有多个以Dify为核心的$199-$499课程,教授非技术人员搭建AI客服、知识库、内容生成等应用。
PydanticAI是2026年增速最快的Agent框架之一,由Pydantic作者Samuel Colvin创建。其核心卖点:将Python类型系统与Agent开发深度绑定,让IDE的自动补全和类型检查成为Agent开发的天然保障。
为什么类型安全在Agent开发中至关重要:Agent系统的核心挑战之一是LLM输出的不可预测性。PydanticAI通过result_type机制强制Agent输出符合预定义的Pydantic Model,在编译期就能捕获大部分类型错误。
# PydanticAI:类型安全的Agent开发
from pydantic_ai import Agent
from pydantic import BaseModel

class AnalysisResult(BaseModel):
    summary: str
    key_findings: list[str]
    confidence_score: float  # 0.0-1.0
    recommendations: list[str]

analysis_agent = Agent(
    model="openai:gpt-4o",
    result_type=AnalysisResult,  # 强制输出符合此类型
    system_prompt="你是一名数据分析师,根据提供的数据生成结构化分析报告。",
)

# 类型安全的调用——IDE自动补全所有字段
result = await analysis_agent.run("分析以下销售数据...")
print(result.data.summary)          # IDE知道这是str
print(result.data.confidence_score)  # IDE知道这是float
生产就绪度评估:PydanticAI目前处于快速迭代期(v0.2.x),尚不适合直接用于核心生产系统。但对于对类型安全有强需求的团队(金融、医疗、航空等受监管行业),它代表了一个值得关注的方向。预计2026年底达到生产就绪状态。
图表 1
Token成本优化四层模型:
| 层级 | 策略 | 典型节省 | 实施复杂度 |
|---|---|---|---|
| L1 模型路由 | 简单问题→小模型,复杂问题→大模型 | 40-60% | 低 |
| L2 语义缓存 | 相似问题复用缓存结果 | 20-35% | 中 |
| L3 上下文压缩 | 压缩历史对话,只保留关键信息 | 15-30% | 中高 |
| L4 Prompt精简 | 系统提示词去冗余,模板化 | 10-15% | 低 |
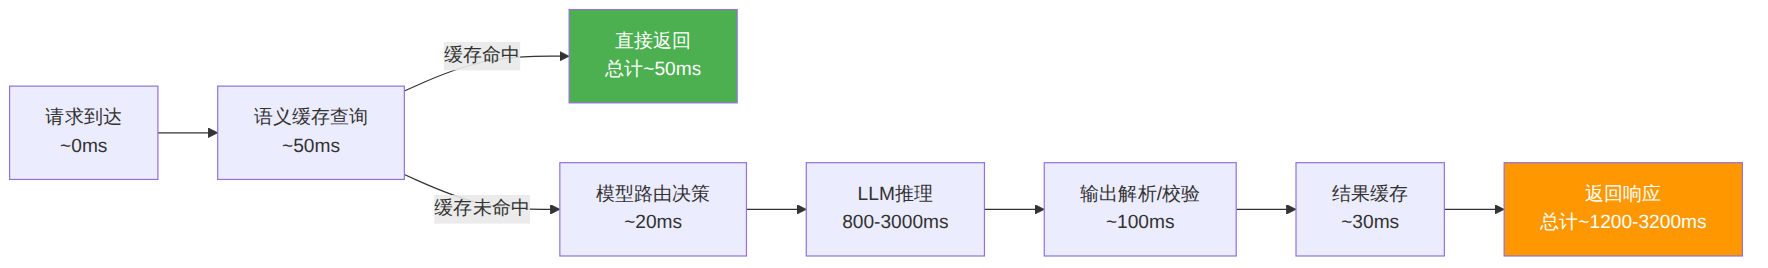
延迟优化关键路径:
图表 2
某SaaS公司部署LangGraph客服Agent的实际优化数据: - 优化前:平均响应2.8秒,月度Token成本$8,200 - 优化后(模型路由+语义缓存+上下文压缩):平均响应1.3秒,月度Token成本$3,100 - ROI:开发投入2人周,3个月回本
图表 3
A2A+MCP双协议融合:Google的Agent-to-Agent (A2A)协议(已于2025年底进入Linux Foundation)和Anthropic的Model Context Protocol (MCP)正在形成互补标准——MCP解决Agent到工具的连接,A2A解决Agent到Agent的通信。2026年下半年,主流框架将同时支持这两个协议,Agent的互操作性将迎来质的飞跃。
框架收敛加速:2024年的Agent框架"寒武纪大爆发"(GitHub 1000+星标的Agent仓库从不到10个暴增至60+个)已经结束。2026年的趋势是收敛——LangGraph、CrewAI、OpenAI Agents SDK形成"三巨头"格局,其余框架要么找到差异化定位(Semantic Kernel锁定企业、Dify锁定低代码),要么逐渐边缘化。
"框架选型"不再是核心问题:越来越多的工程团队意识到,真正的挑战不在框架本身,而在于Context Engineering(上下文工程)、Evaluation(评估体系)和Observability(可观测性)这三大横切关注点。框架只是起点,生产化能力才是护城河。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
