2026年,AI Agent的"工具调用能力"(Tool Use / Function Calling)已从简单的单步API调用,进化为多轮交互、并行执行、推测加速、安全校验的完整技术栈。评测基准也从最初的BFCL单函数测试,扩展到覆盖多步骤链式调用(BFCL v4)、有状态对话式工具使用(ToolSandbox)、MCP协议真实任务(MCPAgentBench)、用户-工具协同交互(τ-bench)等至少八大权威基准。本文横评这八大工具调用评测体系,剖析各前沿模型的真实表现,揭示当前工具调用能力的关键瓶颈与安全风险,并给出面向不同场景的选型建议。
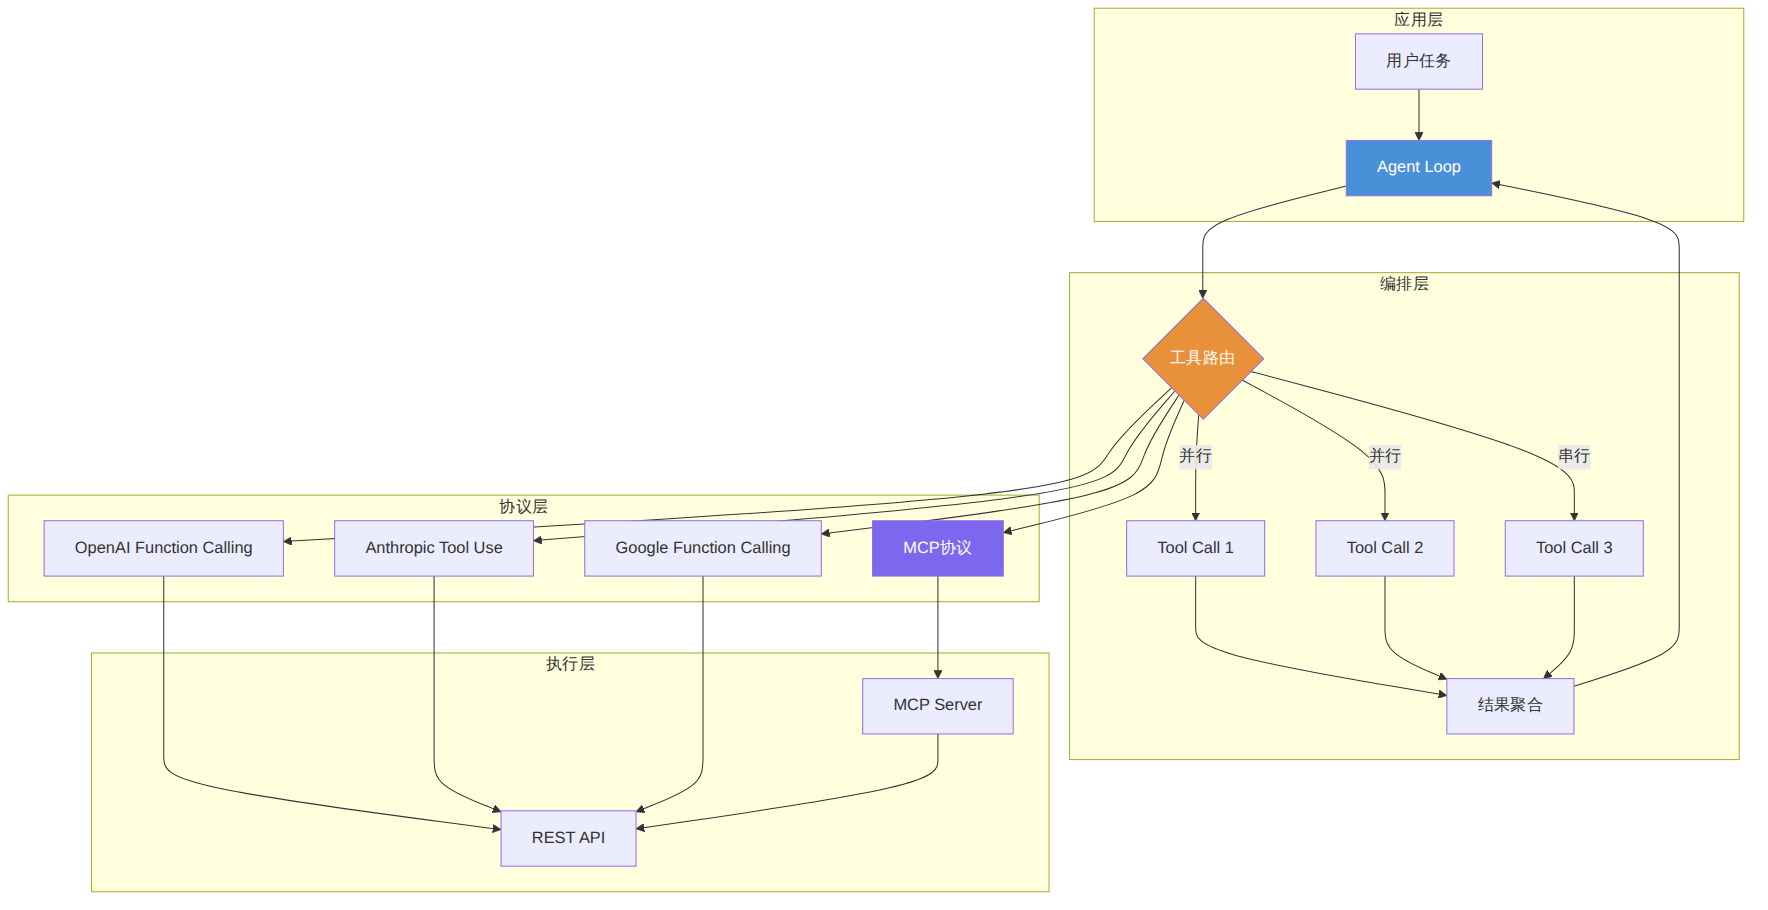
工具调用是AI Agent区别于纯聊天模型的核心能力。一个完整的工具调用循环包括:意图理解→工具选择→参数填充→执行→结果解析→后续决策。2026年的工具调用已形成三层架构:
图表 1
| 评测基准 | 发布方 | 核心定位 | 评测维度 | 工具数量 | 多轮支持 | MCP适配 | 难度等级 |
|---|---|---|---|---|---|---|---|
| BFCL v4 | UC Berkeley Gorilla | 函数调用正确率 | 单/多/并行/链式调用,多语言 | 生成式 | v3起支持 | 否 | ⭐⭐⭐ |
| ToolBench 2.0 | OpenBMB/清华 | 真实API工具链 | 长程多步工具调用 | 16000+ API | 是 | 否 | ⭐⭐⭐⭐ |
| ToolSandbox | Apple | 有状态对话式 | 状态追踪、依赖管理、对话工具使用 | ~30模拟工具 | 是 | 否 | ⭐⭐⭐⭐ |
| MCPAgentBench | 学术论文 | MCP协议真实任务 | MCP工具调用成功率、真实世界任务 | 真实MCP定义 | 是 | 是 | ⭐⭐⭐⭐⭐ |
| MCPToolBench++ | 学术论文 | 大规模MCP工具评测 | 工具调用成功率、参数准确率 | 大规模 | 是 | 是 | ⭐⭐⭐⭐ |
| τ-bench | Sierra Research | 用户-工具-代理协同 | 动态对话+策略遵从+工具使用 | 领域特定 | 是 | 否 | ⭐⭐⭐⭐⭐ |
| GAIA | Meta/学术 | 通用AI助手 | 推理+工具使用+文件处理 | 开放 | 是 | 否 | ⭐⭐⭐⭐⭐ |
| NexusBench | NexusFlow | 开源函数调用 | 多轮Agentic函数调用 | 多领域 | 是 | 否 | ⭐⭐⭐ |
BFCL(Berkeley Function Calling Leaderboard)已迭代至v4版本,是目前业界认可度最高的函数调用基准。v4在v3的多轮评估基础上增加了更复杂的Agentic场景测试,评估维度覆盖:单函数调用(Simple)、多函数选择(Multiple)、并行调用(Parallel)、链式/嵌套调用(Composite),以及跨Python/Java/JavaScript/SQL等多语言测试。
根据2026年5月的公开排行榜数据,各模型表现呈现明显梯队: - 第一梯队(准确率>68%):GPT-5系列、Claude Opus 4.x系列 - 第二梯队(准确率60-68%):Gemini 3.x Pro、Claude Sonnet系列 - 第三梯队(准确率<60%):开源模型中Llama 3.1 405B表现最优
BFCL v4的核心价值在于其可执行验证机制——不仅检查生成的函数调用格式是否正确,还实际执行调用并验证返回结果。这使其区别于纯格式匹配的评测方法,更能反映模型在真实场景中的工具调用可靠性。不过BFCL的局限在于:工具定义均为静态JSON Schema,不涉及有状态交互和真实API环境。
# BFCL评估示例:模型需要从工具列表中选择正确的函数
tools = [{
    "name": "get_weather",
    "description": "获取指定城市的天气",
    "parameters": {
        "type": "object",
        "properties": {
            "city": {"type": "string"},
            "unit": {"type": "string", "enum": ["celsius", "fahrenheit"]}
        },
        "required": ["city"]
    }
}]
# 评估点:参数填充正确性、格式合规性、多函数选择准确率
ToolBench由清华大学OpenBMB团队开发,2024年入选ICLR Spotlight,2025-2026年推出2.0版本。其核心创新在于覆盖16000+个真实RapidAPI接口,要求模型在真实API环境中完成复杂的多步骤任务。
ToolBench 2.0相比1.0的关键升级: - 长程任务:从单步调用扩展到10+步骤的复杂工具链 - 工具检索:引入从海量API中检索正确工具的能力评测 - 鲁棒性评估:测试模型面对API异常、参数缺失等边缘情况的处理能力
评测使用两个核心指标:Pass Rate(任务完成率)和Win Rate(与基线模型的对比胜率)。在ToolBench 2.0上,开源模型ToolLLaMA已接近ChatGPT turbo-16k的工具使用水平,但在长程任务(>8步)上,GPT-5和Claude Opus仍保持显著优势。
ToolBench的实战价值极高——它是少数真正测试模型在"野生"API环境下表现的基准。但其局限在于:评测依赖真实API的可用性,重复性较差,且评测成本较高。
ToolSandbox是Apple研究团队2025年发表于NAACL Findings的论文,其最大创新在于引入有状态(Stateful)工具环境。传统基准假设工具调用是无状态的——每次调用返回固定结果。但真实世界中,工具调用会改变系统状态(如"加入购物车"后再"查看购物车"),模型必须追踪这种状态变化。
ToolSandbox设计了三种评测场景: - 有状态依赖:操作B依赖操作A的结果(先登录再查余额) - 隐式约束:用户偏好对话中的约束("我不要辣的"→后续点餐需遵守) - 多轮对话:用户在对话过程中改变或补充需求
这项评测暴露了一个关键发现:即便是GPT-5级别的模型,在有状态场景下的表现也比无状态场景下降15-25%。这揭示了当前LLM在隐式状态追踪方面的显著弱点。
# ToolSandbox核心:状态感知评估
class StatefulTool:
    def __init__(self):
        self.cart = []
        self.preferences = {}

    def add_to_cart(self, item):
        self.cart.append(item)
        return f"已添加 {item} 到购物车"

    def view_cart(self):
        # 返回结果依赖于之前的状态变更
        return f"购物车: {self.cart}"

    def set_preference(self, key, value):
        self.preferences[key] = value
        # 后续调用需遵守此偏好
随着Anthropic的MCP(Model Context Protocol)在2025-2026年迅速成为AI Agent工具连接的事实标准,专门针对MCP的评测基准应运而生。
MCPAgentBench(2025年12月,arXiv:2512.24565)是基于真实MCP定义设计的评测,核心评估指标包括:工具调用成功率(Tool Call Success Rate)、任务完成率、MCP协议遵循度。其特点是使用真实世界中的MCP Server定义(如文件系统、数据库、搜索工具等),而非人工构造的测试用例。
MCPToolBench++(2025年,arXiv:2508.07575)则聚焦于大规模MCP工具评测,在工具调用成功率基础上,增加了参数准确率(Parameter Accuracy)的细粒度评估。
这两个基准的出现标志着工具调用评测进入了协议感知(Protocol-Aware)时代。在MCPAgentBench上,Claude系列模型由于原生支持MCP协议而具有一定优势,但GPT-5系列通过适配层也展现出极强的竞争力。
τ-bench由Sierra Research开发,是ICLR 2025论文,其独特之处在于测试Tool-Agent-User三方交互。与传统基准只测试模型与工具的交互不同,τ-bench引入了一个模拟用户(由LLM扮演),要求被测Agent同时与工具和用户进行动态对话。
τ-bench目前包含三个领域: - Airline:航空公司客服场景,需处理改签、退票等复杂策略 - Retail:电商零售场景,需遵守价格策略和库存限制 - Banking Knowledge(v3新增):银行知识检索型客服
τ-bench的核心评估点是策略遵从度(Policy Adherence)——Agent不仅要正确调用工具,还必须严格遵守领域规则(如"退票需在起飞前24小时")。在2026年5月的排行榜上,38个模型参与了评估,顶尖模型在Airline领域的通过率仍不足50%,说明工具调用+策略推理的联合能力仍是重大挑战。
GAIA(General AI Assistants)由Meta提出,其设计理念是:如果一个AI系统能够解决GAIA的所有问题,那就意味着实现了真正的通用AI助手。GAIA不仅测试工具调用,还将推理、编码、文件处理、网络搜索等能力融为一体。
GAIA分为三个难度等级(Level 1/2/3),Level 3问题需要多步推理+多种工具协同。截至2026年5月,GAIA Level 3的最高分仍低于40%,这表明当前模型在需要深度推理+工具使用+信息综合的复杂任务上仍有巨大提升空间。
GAIA对工具调用评测的独特贡献在于:它测试的是开放式工具使用——不预设工具列表,Agent需要自主决定何时使用何种工具,这更接近真实世界的使用场景。
NexusBench由NexusFlow AI开发,伴随其开源函数调用模型NexusRaven系列发布。NexusBench的特点是专注于Agentic函数调用——即在多轮Agent循环中的函数调用能力。
与BFCL侧重单步正确率不同,NexusBench测试的是在多轮对话中,模型能否在上下文不断变化的情况下持续正确地调用工具。这包括:对话历史中的工具选择、参数随对话演进而更新、错误恢复(工具调用失败后重试)。
NexusRaven V2在特定函数调用任务上曾达到开源模型SOTA,但在面对闭源顶级模型时仍有差距。NexusBench的价值在于为开源社区提供了可复现的函数调用评测标准。
OSWorld-MCP是OSWorld基准的MCP扩展版本,专注于评测计算机使用(Computer Use)Agent在真实操作系统环境中的工具调用能力。它是首个全面公平地评估Computer-Use Agent通过MCP调用工具能力的基准。
OSWorld-MCP覆盖369个任务,横跨Ubuntu、Windows、macOS三大操作系统。Agent需要通过MCP工具调用完成文件操作、应用控制、数据处理等真实桌面任务。在2026年的评测中,各顶尖Agent在OSWorld-MCP上的表现差距显著,Claude Computer Use和OpenAI Operator处于领先位置。
| 模型 | BFCL v4 | 多步调用 | 有状态场景 | MCP兼容 | 并行调用 | 综合评级 |
|---|---|---|---|---|---|---|
| GPT-5.2/5.5 | ~72% | 优秀 | 良好 | 适配层 | 原生支持 | ⭐⭐⭐⭐⭐ |
| Claude Opus 4.x | ~70% | 优秀 | 良好 | 原生MCP | 支持 | ⭐⭐⭐⭐⭐ |
| Gemini 3.x Pro | ~67% | 良好 | 良好 | 适配层 | 原生支持 | ⭐⭐⭐⭐ |
| Claude Sonnet 4.x | ~70% | 良好 | 良好 | 原生MCP | 支持 | ⭐⭐⭐⭐ |
| Llama 3.1 405B | ~62% | 中等 | 中等 | 需适配 | 有限 | ⭐⭐⭐ |
| DeepSeek V4 | ~60% | 中等 | 中等 | 需适配 | 支持 | ⭐⭐⭐ |
| Qwen 3 | ~58% | 中等 | 中等 | 需适配 | 支持 | ⭐⭐⭐ |
关键发现:所有模型在有状态场景下的表现均显著低于无状态场景,降幅在15-25%之间。这表明工具调用的下一个突破点不在于参数填充的准确率,而在于模型对工具使用上下文和状态变化的深度理解。
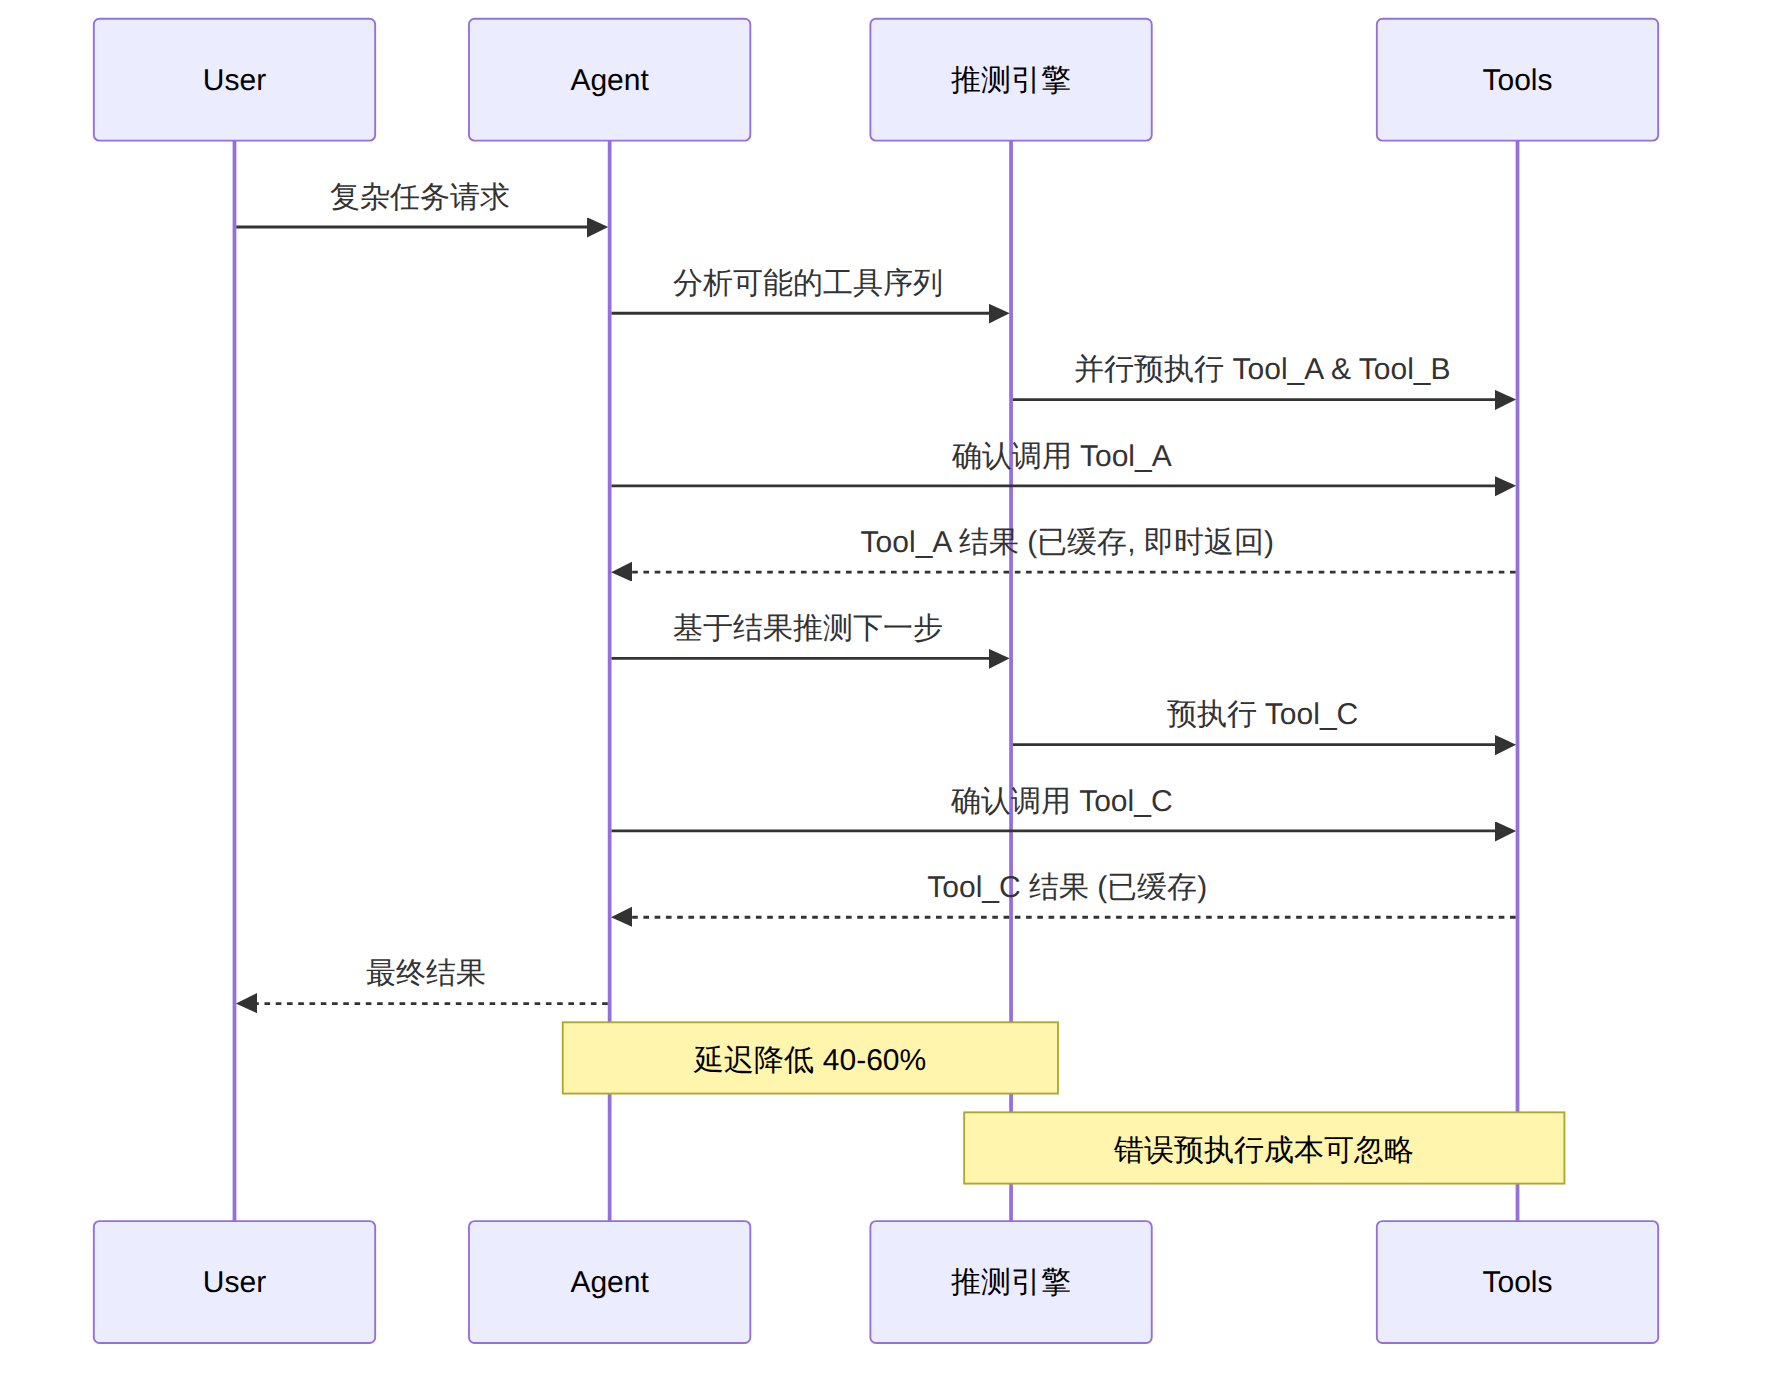
图表 2
2026年最引人注目的工具调用优化方向是推测执行(Speculative Execution)。其核心思路是:在LLM生成工具调用决策之前,推测引擎根据对话上下文预测可能的工具调用序列,并提前执行。如果预测正确,响应延迟可降低40-60%;如果预测错误,只需丢弃结果(成本可忽略)。
学术方面,"Speculative Actions: A Lossless Framework for Faster AI Agents"(OpenReview 2026)提出了无损推测框架;工业方面,"Speculative Tool Execution: Cut Agent Latency 48% in Production"报告了生产环境中48%的延迟降低。当Agent轨迹超过10步且工具以读操作为主时,推测执行带来的加速效果尤为显著。
MCP协议的普及带来了全新的安全攻击面。2026年初发现的关键漏洞CVE-2025-54136揭示了MCP工具投毒(Tool Poisoning)攻击:恶意MCP Server可以通过伪造工具描述和参数,诱导Agent执行非预期操作。
主要攻击类型: - 工具投毒:篡改MCP工具描述,注入恶意指令 - 间接提示注入:通过工具返回内容向Agent注入指令 - Token窃取:利用MCP工具的超权限读取敏感数据 - 供应链攻击:在MCP工具注册表上传恶意工具
防御措施包括:MCP Gateway权限网关、工具签名验证、调用审计日志、沙箱隔离执行等。Microsoft、Elastic、Docker等厂商均已发布MCP安全最佳实践指南。
2025-2026年的一个重要趋势是结构化输出(Structured Output)与工具调用的深度融合。OpenAI、Anthropic、Google均已支持在工具调用中强制使用JSON Schema验证,确保输出100%符合预定义格式。这大幅降低了工具调用在参数格式方面的错误率,使得开发者可以将更多注意力放在工具选择的逻辑正确性上。
基于八大基准的综合分析,当前AI Agent工具调用能力面临以下核心瓶颈:
瓶颈一:长程依赖丢失。 当工具调用链超过8-10步时,模型对早期调用结果的记忆显著衰减,导致后续调用出现参数不一致或重复调用。BFCL v3多轮测试和ToolBench 2.0均验证了这一问题。
瓶颈二:隐式约束遵从。 τ-bench揭示了模型在遵循对话中隐含的策略约束方面表现不佳。例如用户在对话第3轮说"我要最便宜的",模型在第8轮工具调用时可能忽略这一约束。
瓶颈三:错误恢复能力。 当工具调用失败(API超时、参数错误)时,大多数模型缺乏系统性的重试和恢复策略,往往直接向用户报告失败,而非分析原因并调整参数。
瓶颈四:工具选择噪声敏感性。 当可用工具列表超过20个时,模型的工具选择准确率显著下降。NexusBench和BFCL均观察到这一现象,表明工具检索(从候选列表中定位正确工具)本身就是一个未充分研究的子问题。
| 使用场景 | 推荐基准 | 推荐模型 | 关键考量 |
|---|---|---|---|
| 快速API对接 | BFCL v4 | GPT-5.2 / Claude Opus | 格式正确率优先 |
| 复杂工作流 | ToolBench 2.0 | Claude Opus (MCP原生) | 多步骤可靠性 |
| 客服系统 | τ-bench | GPT-5.5 | 策略遵从+对话管理 |
| MCP生态接入 | MCPAgentBench | Claude Opus (原生MCP) | 协议兼容性 |
| 桌面自动化 | OSWorld-MCP | Claude Computer Use | GUI操作能力 |
| 开源部署 | NexusBench | Llama 3.1 + NexusRaven | 成本可控 |
| 研究评测 | GAIA | 多模型对比 | 全面能力评估 |
如果你是企业开发者:优先考虑MCP原生支持(Claude系列)或生态成熟度(GPT-5系列),并重点关注τ-bench风格的策略遵从测试。
如果你是研究人员:建议使用BFCL v4作为基础评测,叠加ToolSandbox的有状态测试和GAIA的开放式评测,以全面评估模型的工具调用能力。
如果你是开源实践者:NexusRaven + Llama 3.1的组合在特定场景下已可匹敌闭源模型的中等水平,适合预算有限的场景。关注ToolBench的开源工具集,可大幅降低评测门槛。
变现潜力评估:工具调用能力的培训和咨询服务是2026年AI培训市场的热门方向。以"Function Calling实战训练营"为主题的课程,结合BFCL基准的可量化指标,市场定价在2000-5000元/人具有竞争力。企业级MCP安全审计工具和Tool Calling评测SaaS平台也具有较高的商业化价值。
延伸阅读: - BFCL v4排行榜:gorilla.cs.berkeley.edu/leaderboard.html - ToolSandbox论文:arxiv.org/abs/2408.04682 - MCPAgentBench论文:arxiv.org/abs/2512.24565 - τ-bench项目:taubench.com - GAIA排行榜:huggingface.co/spaces/gaia-benchmark/leaderboard - 推测执行研究:arxiv.org/pdf/2512.15834 - MCP安全分析:arxiv.org/html/2601.17549v1
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
