2026年,Tool Use(工具调用)已从"锦上添花"进化为AI Agent的核心生存技能。Berkeley BFCL v4排行榜上,GPT-5.2以57.5%的SOTA成绩领跑,但领先优势正在缩小。MCP协议生态突破13,000+服务器、月下载量9,700万次,成为事实标准。Google Gemini 3率先实现内置工具(Search/Maps/Code Execution)与自定义Function Calling的单次API混合调用。更具突破性的是,投机执行(Speculative Execution)技术可将Agent工具调用延迟降低48%。本文从六大主流LLM的Function Calling实现、五大评测基准、MCP生态演进、延迟优化前沿四大维度,全景剖析2026年AI Agent工具调用能力的真实水平。
| 维度 | OpenAI GPT-5.2 | Claude Opus 4.6 | Gemini 3 Pro | Grok 4.3 | DeepSeek V4 | Qwen 3 |
|---|---|---|---|---|---|---|
| 并行调用 | ✅ 原生支持 | ✅ 原生支持 | ✅ 原生支持 | ✅ 支持 | ✅ 支持 | ✅ 支持 |
| Structured Output | ✅ JSON Schema严格模式 | ✅ 强制JSON输出 | ✅ JSON模式 | ⚠️ 基础 | ✅ 支持 | ✅ 支持 |
| tool_choice控制 | auto/required/none/指定函数 | auto/any/tool | auto/required/none | auto/required | auto/none | auto/none |
| Streaming | ✅ 工具调用流式 | ✅ | ✅ | ✅ | ✅ | ✅ |
| 内置工具 | Code Interpreter, File Search | Computer Use, Bash, Text Editor | Search, Maps, Code Exec, URL Context | Web Search, Code Exec | - | - |
| MCP兼容 | ✅ Agents SDK | ✅ 原生MCP | ✅ Vertex AI集成 | ⚠️ 部分 | ⚠️ 社区实现 | ⚠️ 社区实现 |
| BFCL v4得分 | ~57.5% (SOTA) | ~54% | ~52% | ~48% | ~45% | ~42% |
| 定价(input/output) | $2.50/$10 | $15/$75 | $1.25/$5 | $3/$15 | $0.27/$1.10 | $0.50/$2 |
| 最大上下文 | 128K | 1M | 1M | 1M | 128K | 128K |
注:BFCL v4得分因评测时间不同可能有波动,以上为2026年4-5月公开数据近似值。
OpenAI在Function Calling领域积累最深,GPT-5.2代表了当前工具调用的最高准确率。
核心架构改进:
GPT-5.2引入了三个关键变化。第一,tool_choice参数支持四种粒度——auto(模型自主决策)、required(必须调用至少一个工具)、none(禁止调用)、以及直接指定函数名(强制调用特定函数)。第二,Structured Output通过JSON Schema严格模式保证输出100%符合预定义格式,消除了传统Function Calling中参数解析失败的痛点。第三,并行工具调用(Parallel Tool Calling)允许模型在单次推理中同时请求多个工具,大幅降低多步骤任务的延迟。
# GPT-5.2 并行工具调用示例
tools = [
    {
        "type": "function",
        "function": {
            "name": "get_weather",
            "description": "获取指定城市的天气",
            "parameters": {
                "type": "object",
                "properties": {
                    "city": {"type": "string"},
                    "unit": {"type": "string", "enum": ["celsius", "fahrenheit"]}
                },
                "required": ["city"],
                "additionalProperties": False  # 严格模式
            },
            "strict": True  # 启用Structured Output
        }
    },
    {
        "type": "function",
        "function": {
            "name": "get_stock_price",
            "description": "获取股票价格",
            "parameters": {
                "type": "object",
                "properties": {"symbol": {"type": "string"}},
                "required": ["symbol"],
                "additionalProperties": False
            },
            "strict": True
        }
    }
]

response = client.chat.completions.create(
    model="gpt-5.2",
    messages=[{"role": "user", "content": "北京天气如何?AAPL现在多少钱?"}],
    tools=tools,
    tool_choice="auto"  # 模型智能决策
)

# 模型可能在单次响应中并行调用两个工具
for tool_call in response.choices[0].message.tool_calls:
    print(f"调用: {tool_call.function.name}")
    print(f"参数: {tool_call.function.arguments}")
优缺点分析:
优势方面,GPT-5.2的strict: true模式在BFCL v4中取得了最高的参数格式准确率(超过98%的JSON Schema合规率),这意味着开发者不再需要手写参数校验逻辑。并行调用在需要同时查询多个API的场景(如金融数据聚合)中可节省50-70%的延迟。
劣势在于定价较高($2.50/$10 per M tokens),且strict模式目前不支持所有JSON Schema特性(如oneOf、patternProperties等高级校验规则)。
变现评估: 适合构建高价值自动化工作流——法律合同审查(结构化提取条款)、金融报表分析(批量API调用聚合)。训练营方向可定位为"企业级Agent工具调用最佳实践"。
Anthropic在工具调用上走了一条完全不同的路线——不只做Function Calling,而是让AI直接"操作"真实工具。
三大工具类型:
Claude的工具体系分为三类:Client Tools(客户端工具,即传统Function Calling)、Computer Use Tools(计算机操作工具,包括屏幕截图、鼠标键盘操作)、Bash & Text Editor Tools(命令行和文件编辑工具)。
# Claude Opus 4.6 Computer Use + Function Calling 混合示例
import anthropic

client = anthropic.Anthropic()

# 定义传统Function Calling工具
analysis_tools = [
    {
        "name": "query_database",
        "description": "查询SQL数据库",
        "input_schema": {
            "type": "object",
            "properties": {
                "query": {"type": "string", "description": "SQL查询语句"},
                "database": {"type": "string", "enum": ["production", "staging"]}
            },
            "required": ["query"]
        }
    }
]

# 同时使用Computer Use和Function Calling
response = client.beta.messages.create(
    model="claude-opus-4-6",
    max_tokens=1024,
    tools=[
        # 内置Computer Use工具
        {"type": "computer_20250124", "name": "computer",
         "display_width_px": 1920, "display_height_px": 1080},
        # 内置Bash工具
        {"type": "bash_20250124", "name": "bash"},
        # 自定义Function Calling工具
        *analysis_tools
    ],
    messages=[{
        "role": "user",
        "content": "查询production库的用户表,然后在浏览器中打开管理后台验证数据"
    }],
    betas=["computer-use-2025-01-24"]
)
Advanced Tool Use新特性(2025年11月发布):
Anthropic在2025年底推出的三项高级工具使用功能值得关注:
Tool Search Tool:允许Claude在运行时从已注册的工具库中搜索和选择最合适的工具,而不是一次性传入所有工具定义。这对于拥有数百个工具的大型企业系统至关重要。
Code Execution Tool:在沙箱中执行Python代码,支持文件读写、安装包、运行分析脚本。不同于简单的代码解释器,它与Claude的推理深度结合。
MCP原生集成:Claude是第一个原生支持MCP协议的LLM。通过Claude Desktop和Claude Code,开发者可以直接连接数千个MCP Server,无需手动编写工具定义。
优缺点分析:
优势在于工具类型最丰富(GUI操作 + 命令行 + API调用 + MCP生态),特别适合需要操作桌面应用的场景(ERP系统、内部工具、遗留软件)。1M token上下文窗口允许传入大量工具定义。
劣势是价格最高($15/$75),Computer Use仍为Beta且需要Docker容器化环境运行。
Google在2026年3月推出的Gemini API Tooling Updates,是工具调用领域最被低估的创新。
Context Circulation + Tool Combos:
传统Function Calling的痛点是:内置工具(如搜索、代码执行)和自定义函数无法在同一个API调用中共存。Gemini 3率先解决了这个问题——开发者可以在一个generateContent请求中同时使用Google Search Grounding、Google Maps、Code Execution和自定义Function Calling。
# Gemini 3 Tool Combo: 搜索 + 地图 + 自定义函数 单次调用
import google.generativeai as genai

tools = [
    {"google_search": {}},           # 内置搜索
    {"google_maps": {}},             # 内置地图
    {"code_execution": {}},          # 内置代码执行
    # 自定义Function Calling
    {
        "function_declarations": [{
            "name": "book_restaurant",
            "description": "预订餐厅",
            "parameters": {
                "type": "OBJECT",
                "properties": {
                    "restaurant_id": {"type": "STRING"},
                    "party_size": {"type": "INTEGER"},
                    "datetime": {"type": "STRING"}
                },
                "required": ["restaurant_id", "party_size", "datetime"]
            }
        }]
    }
]

model = genai.GenerativeModel('gemini-3-pro', tools=tools)
response = model.generate_content(
    "帮我找北京朝阳区评分最高的日料店,看看地图上的位置,计算从国贸出发的驾车时间,然后预订今晚7点4人位"
)
# Gemini 3 可以在单个调用链中:
# 1. 用Google Search搜索餐厅
# 2. 用Google Maps获取位置和路线
# 3. 用Code Execution计算驾车时间
# 4. 用自定义函数预订餐厅
Parallel Tool IDs机制:
Gemini 3引入了parallel_tool_ids参数,允许开发者在单次请求中指定需要并行执行的工具组合。配合Context Circulation(上下文循环),前一个工具的输出可以自动作为下一个工具的输入参数,无需开发者手动拼接中间结果。
优缺点分析:
Gemini 3 Pro的性价比最高($1.25/$5),工具组合能力最强。但自定义Function Calling的参数格式合规率略低于GPT-5.2,在复杂嵌套Schema场景中偶尔出现字段遗漏。
变现方向: LBS(Location-Based Service)类应用是Gemini 3的杀手场景。旅游规划、本地生活、物流调度——任何需要地图+搜索+自定义API组合的场景,Gemini 3是唯一能"一个API搞定"的选择。
DeepSeek V4于2026年4月发布,在BFCL v4上取得了约45%的得分——虽然距离GPT-5.2有差距,但考虑到其价格仅为$0.27/$1.10,性价比极为突出。
# DeepSeek V4 Function Calling(OpenAI兼容接口)
from openai import OpenAI

client = OpenAI(
    api_key="your-deepseek-key",
    base_url="https://api.deepseek.com"
)

response = client.chat.completions.create(
    model="deepseek-v4-pro",
    messages=[{"role": "user", "content": "搜索Python最新的异步框架"}],
    tools=[{
        "type": "function",
        "function": {
            "name": "web_search",
            "description": "搜索互联网",
            "parameters": {
                "type": "object",
                "properties": {"query": {"type": "string"}},
                "required": ["query"]
            }
        }
    }],
    tool_choice="auto"
)
DeepSeek V4的Function Calling完全兼容OpenAI API格式,迁移成本几乎为零。对于需要本地部署或成本敏感的场景(如初创公司内部工具、学生项目),它是最佳选择。
Grok 4.3在2026年5月上线,xAI明确将其定位为"best for agentic tool calling"。支持1M上下文窗口,并内置Web Search和Code Execution。
Grok 4.3的特色在于其agentic tool loop的稳定性——在多轮工具调用(10+步)的长链路场景中,Grok 4.3的工具选择一致性表现突出,不太容易出现"调用到一半忘记目标"的问题。这与其强化学习训练中专门针对多步agent轨迹优化有关。
| 基准名称 | 发布方 | 核心评估维度 | 测试规模 | 特色 |
|---|---|---|---|---|
| BFCL v4 | UC Berkeley | 串行/并行/多轮函数调用 | 2,000+测试用例 | 首个可执行评测,真实API调用 |
| ToolBench | Tsinghua | RapidAPI跨域工具使用 | 16,000+API | 覆盖真实世界API最广 |
| API-Bank | AliCloud | 工具规划+调用+检索 | 3层73个API | 首个分层评测框架 |
| ToolAlpaca | CMU | 紧凑模型工具泛化 | 4,000+工具 | 专注小模型能力评估 |
| τ-bench | — | 多步骤Agent工作流 | 真实客服场景 | 最接近生产环境 |
BFCL v4从四个子维度评估Function Calling能力:
Simple Function Calling:单函数、少量参数,测试基本的工具选择和参数填充。所有主流模型在此维度均达到90%+准确率,已无区分度。
Multiple Function Calling:从10-50个候选函数中选择正确的函数并填写参数。这里开始出现显著差距——GPT-5.2在50个候选函数场景下仍保持85%准确率,而部分开源模型降至60%以下。
Parallel Function Calling:在单次推理中正确调用多个独立函数。这是2026年新增的评测维度,GPT-5.2和Claude Opus 4.6表现最佳,Gemini 3紧随其后。
Multi-Step Function Calling:需要3-10步的函数调用链,前一步的输出作为后一步的输入。这是最具挑战性的维度,所有模型表现大幅下降。GPT-5.2约为57%,Claude Opus 4.6约54%,但多数模型低于40%。
关键发现: 当前工具调用的瓶颈不是"调用参数格式",而是"多步骤规划"。模型在面对需要5步以上的工具链路时,错误类型从"参数格式错"转变为"规划失误"——选错工具、遗漏步骤、或混淆中间结果。
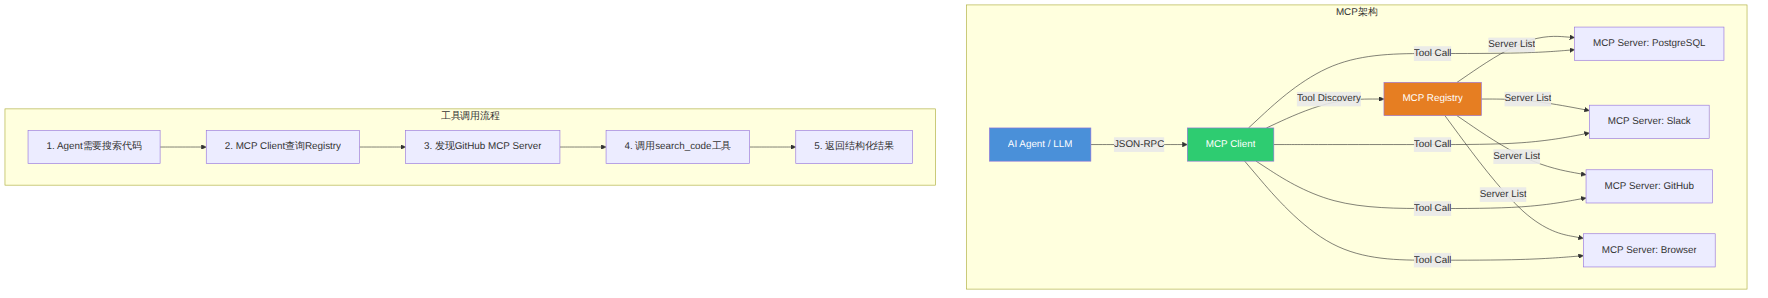
Model Context Protocol(MCP)从2024年底Anthropic发布至今,已发展为AI工具调用领域的事实标准。2026年的关键里程碑:
图表 1
传统Function Calling的流程是:开发者手动定义工具Schema → 传入LLM → LLM生成调用指令 → 开发者执行。MCP改变了这一范式——工具定义由Server提供,Client自动发现和适配,LLM只需要选择调用。
这意味着:新增一个工具不再需要修改Agent代码,只需要启动一个MCP Server。 对于企业而言,这是从"硬编码集成"到"即插即用"的根本转变。
2026年工具调用领域最值得关注的研究方向是Speculative Execution(投机执行)。
传统Agent Loop是串行的:LLM推理 → 决定调用工具 → 执行工具 → 返回结果 → LLM继续推理。每一步都必须等待上一步完成。
投机执行的思路是:在LLM推理的同时,预测它可能需要的工具调用并提前执行。 如果预测正确,直接使用预执行结果,跳过等待;如果预测错误,丢弃结果,回退到正常流程。
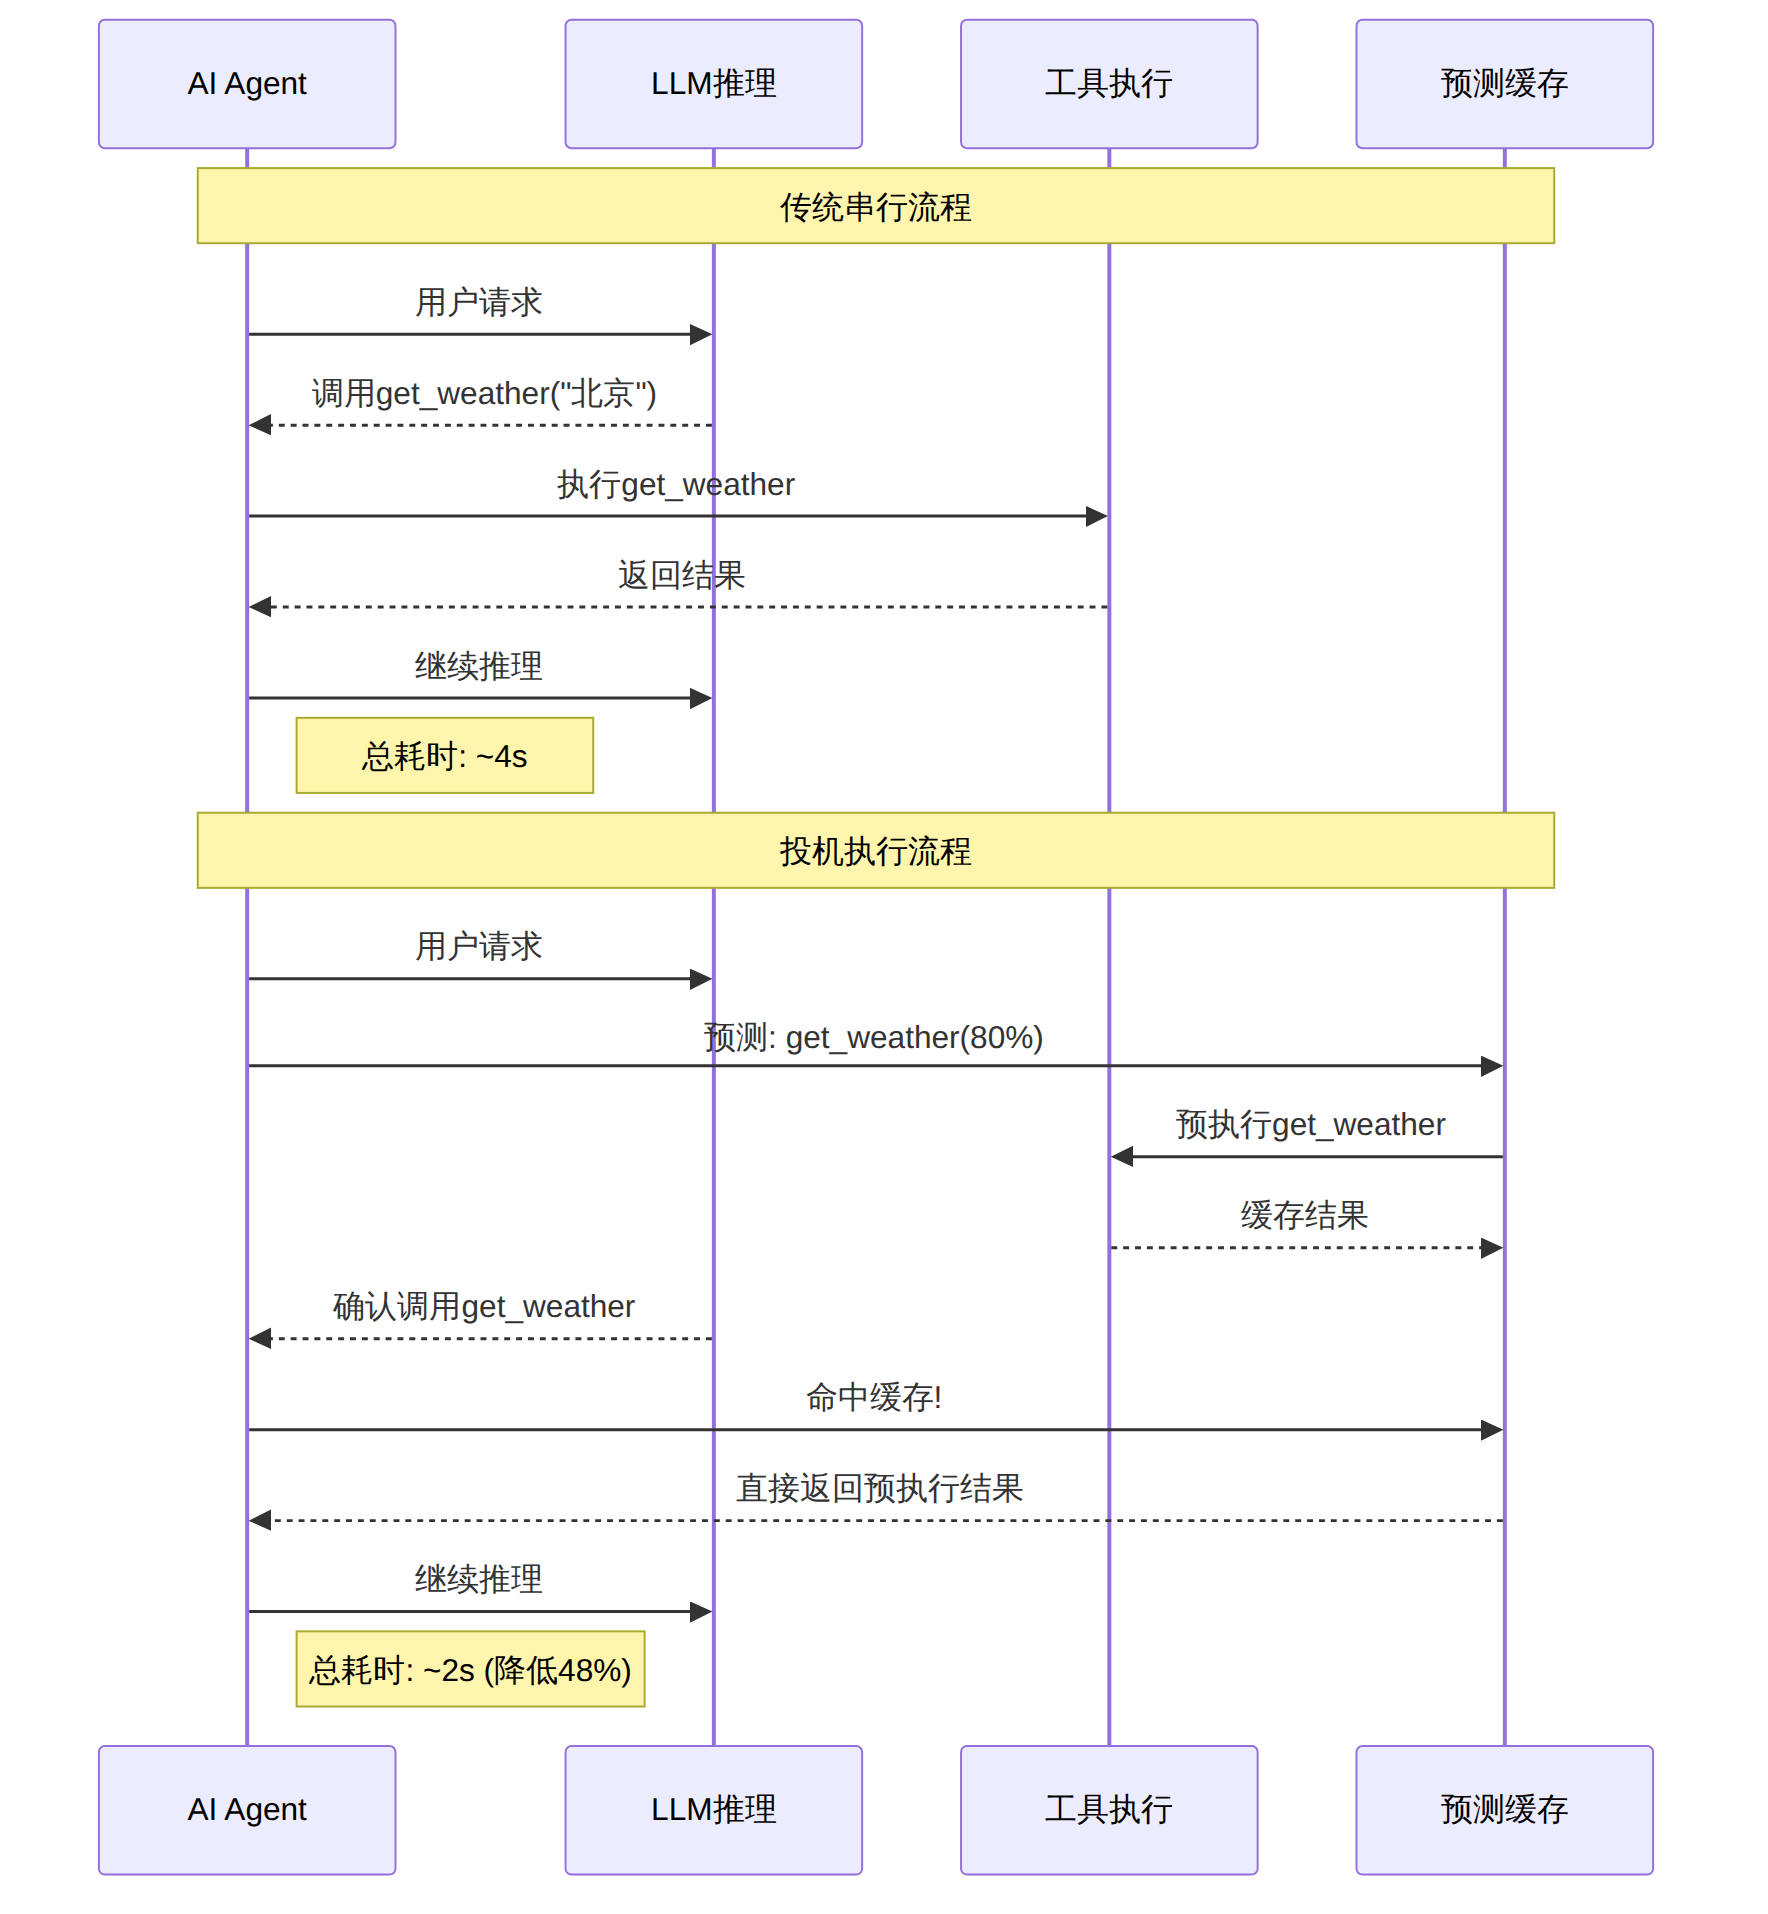
图表 2
根据ReplyAnt实验室2026年的生产环境测试:
论文《Speculative Actions: A Lossless Framework for Faster Agentic Systems》(OpenReview 2026)证明,该框架是无损的——预测错误时不会影响最终结果正确性,只会退化为正常延迟。
生产落地建议: 对于读多写少的Agent工作流(如数据查询、信息聚合),投机执行是2026年最值得尝试的延迟优化手段。
一个完整的Agent工具调用系统包含五个层次:
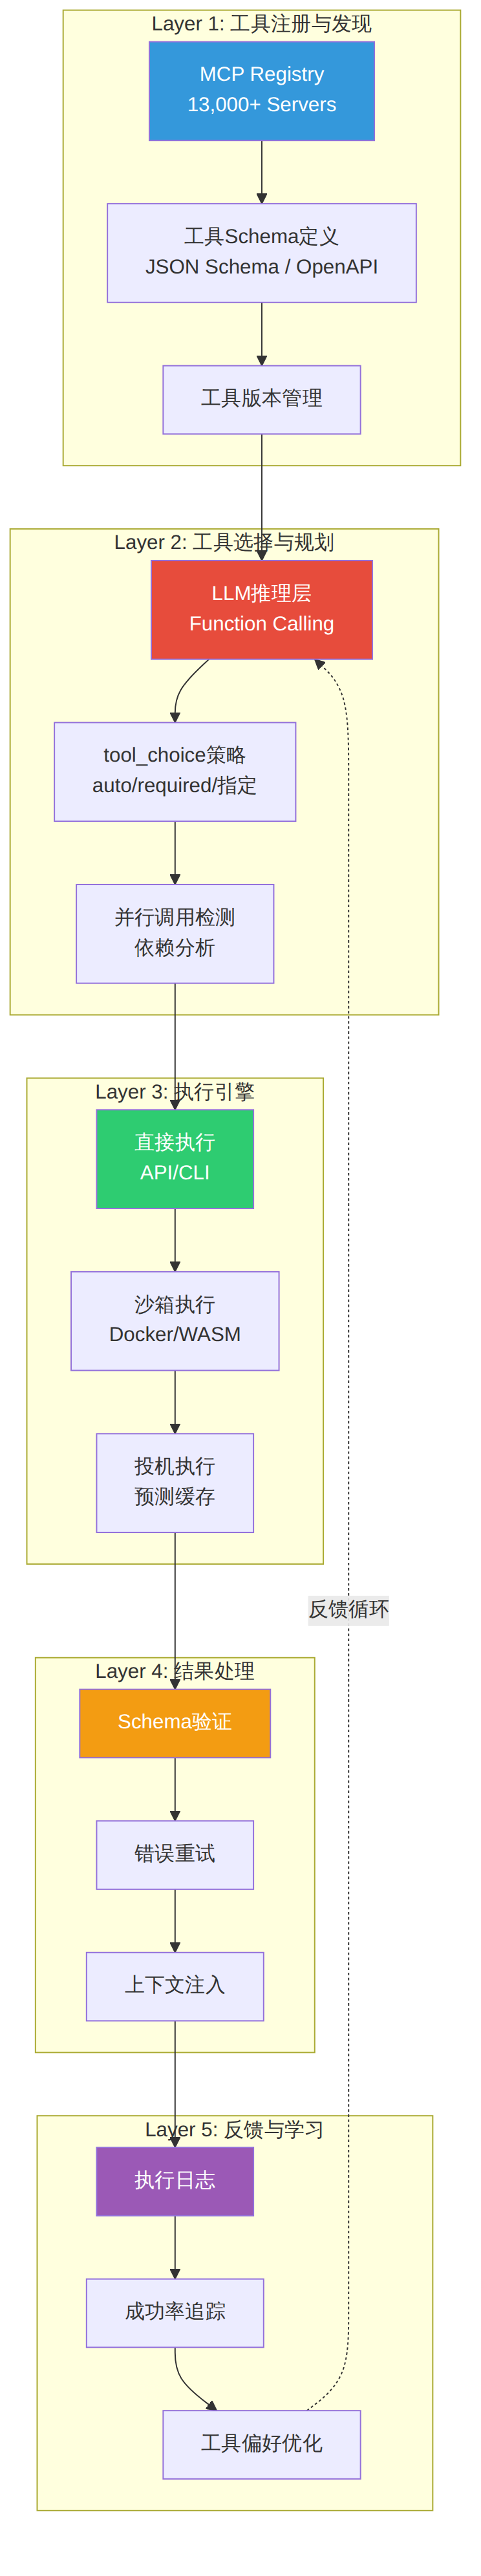
图表 3
当Agent需要调用500+外部工具时,逐一手写Function Calling定义是不现实的。Composio、StackOne、Truto等工具集成平台正在填补这一空白。
Composio提供1,000+预构建工具集成,覆盖Slack、GitHub、Salesforce、Google Workspace等主流SaaS。核心价值在于:
# Composio + OpenAI Agent 示例
from composio_openai import ComposioToolSet, App
from openai import OpenAI

toolset = ComposioToolSet()
tools = toolset.get_tools(
    apps=[App.GITHUB, App.SLACK, App.NOTION]  # 一行代码获取3个平台的工具
)

client = OpenAI()
response = client.chat.completions.create(
    model="gpt-5.2",
    messages=[{"role": "user", "content": "在GitHub上创建一个新issue,然后发Slack通知"}],
    tools=tools  # 直接传入Composio提供的工具定义
)

# Composio自动处理认证和执行
result = toolset.handle_tool_calls(response)
2026年一个重要趋势是Structured Output与Function Calling的深度融合。OpenAI率先在GPT-5中统一了两者——Function Calling本质上就是"结构化输出的一个特例"。
三种输出结构化方式的定位:
| 方式 | 用途 | 保证程度 | 适用场景 |
|---|---|---|---|
| JSON Mode | 确保输出合法JSON | 语法级 | 简单数据提取 |
| Structured Output | 确保输出符合JSON Schema | Schema级 | 表单填充、数据录入 |
| Function Calling | 调用外部工具 | Schema + 语义级 | Agent工具调用 |
生产环境最佳实践:对于不需要执行外部API的场景(如信息抽取),优先使用Structured Output而非Function Calling,因为前者不消耗工具调用的额外token开销。
推荐:Claude Opus 4.6 + MCP
理由:企业内部系统多为桌面应用或老旧Web界面,Computer Use + MCP的组合可以操作几乎所有遗留系统。1M上下文窗口允许注册大量内部工具。
推荐:Gemini 3 Pro + Tool Combo
理由:搜索+地图+代码执行+自定义函数的单API调用能力,是最适合信息聚合场景的方案。极低的价格($1.25/$5)适合面向大量用户的C端产品。
推荐:GPT-5.2 + OpenAI Agents SDK
理由:最高准确率的Function Calling + 并行调用 + Structured Output,配合Agents SDK的内置handoff和guardrail机制,适合构建可靠的代码助手。
推荐:DeepSeek V4-Pro + Composio
理由:DeepSeek V4的Function Calling兼容OpenAI格式,Composio提供开箱即用的500+工具集成。总成本可控制在GPT方案的1/10以内。
推荐:Grok 4.3 + 投机执行
理由:Grok 4.3在长链路场景的工具选择一致性最佳。配合投机执行优化,可将10步以上的工具链路延迟降低40-50%。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
