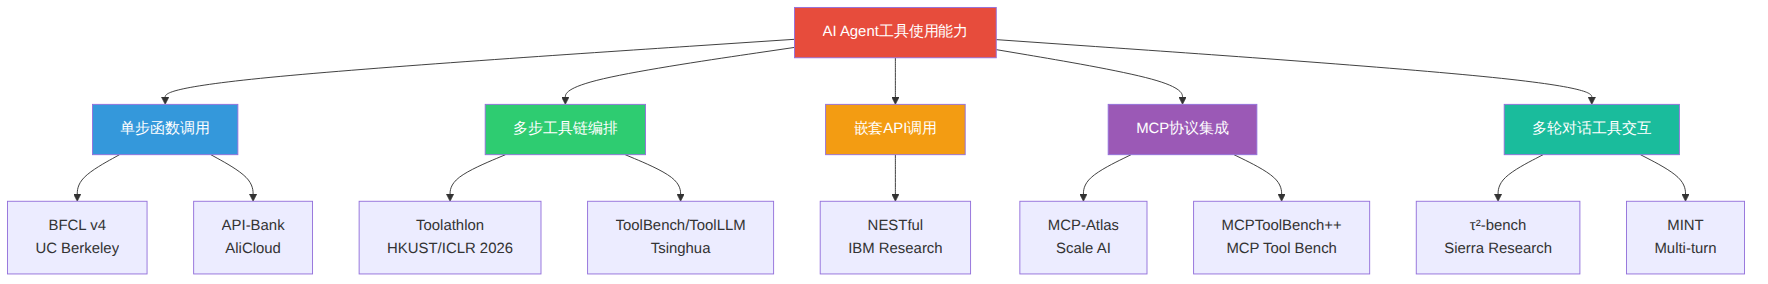
2026年,AI Agent的核心竞争力已经从"能对话"转向"能用工具"。Function Calling、Tool Use能力成为衡量LLM Agent实战价值的第一指标。本文深度剖析七大工具使用评测基准(BFCL v4、MCP-Atlas、τ²-bench、Toolathlon、NESTful、MCPToolBench++等),揭示一个残酷现实:实验室Benchmark得分80%+的模型,在生产环境中成功率暴跌至40%以下,37%的性能鸿沟正在重塑整个Agent工具链生态。从OpenAI的Structured Outputs到Anthropic的MCP协议,从Salesforce的xLAM专用模型到Google的A2A互操作协议,工具使用能力已成为AI Agent领域最激烈的战场。
2025-2026年,AI Agent工具使用评测领域涌现出多个重量级基准测试,形成了从单一函数调用到复杂多步骤工具编排的完整评测体系。Philipp Schmid(Hugging Face)整理的AI Agent Benchmark Compendium收录了超过50个相关评测基准,以下是最具影响力的七大基准:
| 基准名称 | 发布机构 | 核心评测维度 | 数据规模 | 关键发现 |
|---|---|---|---|---|
| BFCL v4 | UC Berkeley (Gorilla) | 函数调用准确性、并行调用、多函数选择 | 2,000+问题-函数-答案对 | 闭源模型全面领先,开源模型差距显著 |
| MCP-Atlas | Scale AI | MCP协议工具使用、多工具协同 | 1,000人工标注任务,36个真实MCP服务器 | Claude在MCP工具使用上表现突出 |
| τ²-bench | Sierra Research | 双控对话式工具交互、客服场景 | 500+新任务,88个模型评测 | 最佳Agent仅解决67%客服任务 |
| Toolathlon | HKUST (ICLR 2026) | 十类工具全能评估、真实环境 | 多领域工具组合任务,18个模型 | 大多数模型在复杂工具链上崩溃 |
| NESTful | IBM Research | 嵌套API调用序列 | 1,800+嵌套序列 | 嵌套调用是当前模型最大弱点 |
| MCPToolBench++ | MCP Tool Bench团队 | MCP工具调用、多域评估 | 大规模多域基准 | MCP工具发现和选择仍是大挑战 |
| AgentBoard | 多机构合作 | 全维度Agent评估 | 多任务类型 | 规划+工具联合能力最稀缺 |
图表 1
Berkeley Function Calling Leaderboard(BFCL)由UC Berkeley的Gorilla项目团队开发,是业界公认评估LLM函数调用能力的事实标准。BFCL v4是目前最新版本,已作为ICML 2025论文正式发表。
BFCL v4的设计覆盖了函数调用的全频谱能力:
根据BFCL v4排行榜的最新数据,闭源模型在函数调用准确性上占据绝对优势。GPT-4.1系列和Claude Sonnet 4.6在总排名上交替领先,而开源模型即使是参数量更大的版本,在复杂函数调用场景中仍然存在显著差距。
特别值得关注的是,BFCL v4引入了Prompt-based评估(即不使用原生函数调用能力,而是通过prompt工程模拟函数调用)与Native FC(原生函数调用支持)的对比。结果显示,原生函数调用支持的模型在准确率上比prompt-based方案高出15-25个百分点,这证明了原生工具使用支持的重要性。
# BFCL v4标准评测输入格式示例
test_case = {
    "question": "What's the weather in Paris and Tokyo?",
    "function": [
        {
            "name": "weather_get_weather",
            "description": "Get current weather for a location",
            "parameters": {
                "type": "object",
                "properties": {
                    "location": {
                        "type": "string",
                        "description": "City name"
                    }
                },
                "required": ["location"]
            }
        }
    ],
    # 期望输出:并行调用两个城市的天气查询
    "expected_output": [
        {"weather_get_weather": {"location": "Paris"}},
        {"weather_get_weather": {"location": "Tokyo"}}
    ]
}

# 评测评分维度
evaluation_metrics = {
    "exec_accuracy": "执行结果是否正确",
    "type_match": "参数类型是否严格匹配",
    "hallucination_rate": "是否生成了不存在的函数",
    "missing_rate": "是否遗漏了应该调用的函数"
}
变现评估:BFCL评测方法论本身可以包装为"AI函数调用能力测评训练营",面向企业客户,评估其选择的LLM在特定业务场景的函数调用可靠性。潜在定价3-5万/次,市场空间广阔。
MCP-Atlas由Scale AI于2025年发布,是首个基于真实MCP(Model Context Protocol)服务器的大规模工具使用评测基准。这一基准的出现标志着工具使用评测从"模拟API"进入了"真实协议对接"的新阶段。
MCP-Atlas包含36个真实MCP服务器,涵盖数据库操作、文件系统、代码执行、网络请求、图像处理等多个领域。每个任务都需要Agent在多个MCP服务器之间协调工作,这比传统的单API调用评测复杂度提升了数个量级。
关键数据: - 1,000个人工标注任务:每个任务由领域专家设计,包含明确的成功标准 - 多工具协同:平均每个任务需要调用3-7个不同工具 - 真实服务器执行:不是模拟,而是真正连接MCP服务器执行操作
MCP-Atlas排行榜显示,在MCP工具使用场景下: - Claude Sonnet 4.6在MCP-Atlas上的表现甚至优于Claude Opus 4.6,表明Anthropic在中等规模模型上针对MCP做了专门优化 - GPT系列在结构化工具调用上表现稳定,但在需要多工具编排的复杂任务中开始出现断裂 - 开源模型在MCP场景中的表现远不如其在BFCL上的表现,说明MCP协议理解是一个更高阶的能力
MCP-Atlas的评测方法论直接对应企业级需求——"我的Agent能否可靠地使用MCP工具生态"。可以发展为: - MCP工具兼容性认证服务 - 企业MCP服务器接入前的Agent能力预检工具 - MCP工具选择咨询(哪些MCP服务器组合最适合特定Agent)
τ²-bench(tau-squared-bench)由Sierra Research开发,是τ-bench的升级版本,专注于评估Agent在双控对话场景下的工具使用能力。其创新之处在于模拟了一个更真实的交互环境:不仅有Agent和用户之间的对话,还有Agent与工具之间的交互,形成了三方博弈。
传统评测基准只测试Agent在单控环境(只有Agent控制工具调用)下的表现。τ²-bench引入了双控概念: - Agent需要与用户进行自然语言对话,理解用户意图 - 同时Agent需要调用正确的工具执行操作 - 用户会根据Agent的响应进行追问、纠正或要求修改
这种设计更接近真实的客服、运维、销售助理等场景。
根据2026年的评测数据: - 最佳Agent仅能解决67%的客服任务——这个数字远低于大多数Benchmark上的表现 - Anthropic的Claude系列模型在τ²-bench上占据领先位置,这与Claude在多轮对话中的强一致性密切相关 - 88个被评测的模型中,超过60%的模型得分低于40%,说明在真实的对话式工具交互中,大多数模型的工具使用能力严重不足
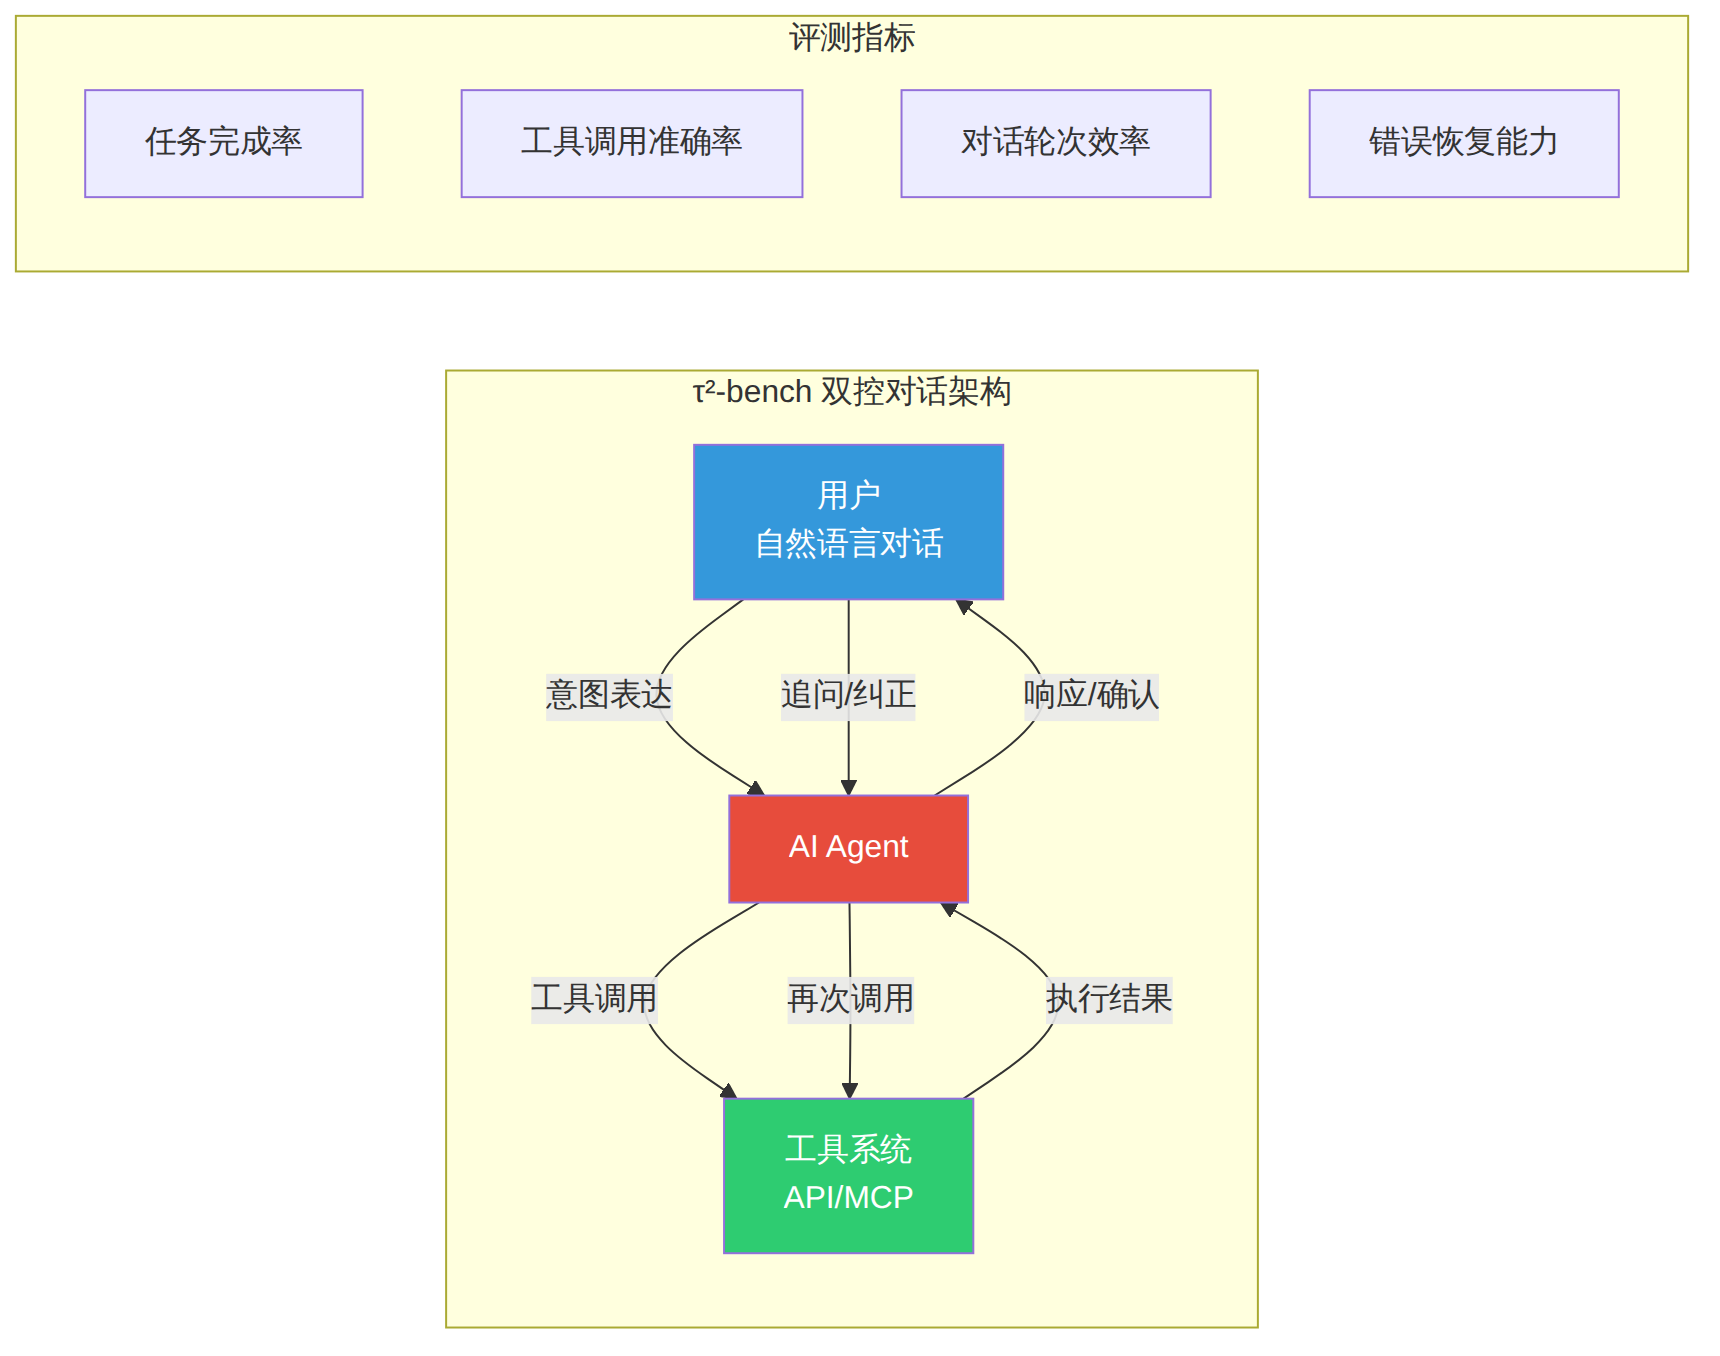
图表 2
τ²-bench揭示了一个关键问题:大多数Agent在简单的单次工具调用中表现良好,但在多轮对话中维护上下文并持续正确使用工具的能力急剧下降。这是生产环境中最常见的失败模式之一。
Toolathlon(The Tool Decathlon)由香港科技大学(HKUST)研究团队开发,已作为ICLR 2026论文被接收。这个基准的名字就揭示了它的核心理念——像田径十项全能一样,全面评估Agent在十类不同工具上的使用能力。
Toolathlon覆盖了软件工具生态中最常见的十类工具操作: 1. 文件系统操作:读写、搜索、重命名文件 2. 代码执行:运行Python/Shell命令并处理输出 3. 数据处理:CSV/JSON数据的过滤、排序、聚合 4. 网络请求:HTTP API调用、参数构建 5. 数据库查询:SQL生成与执行 6. 图像处理:图像转换、裁剪、滤镜 7. 文本处理:正则匹配、格式转换 8. 系统管理:进程管理、环境配置 9. 版本控制:Git操作、分支管理 10. 通信工具:邮件发送、消息通知
根据Toolathlon排行榜(18个模型评测): - 没有模型在所有十类工具上都能达到80%以上的成功率——这是所有Benchmark中最残酷的现实 - 模型在文件操作和代码执行上表现最好(75-85%),但在数据库查询和系统管理上表现最差(35-50%) - 工具链长度是最大的衰减因子:当任务需要串联4个以上工具时,所有模型的性能至少下降30% - 开源模型(如Llama系列)在Toolathlon上的表现与闭源模型的差距比BFCL更大
# Toolathlon评测示例:多工具协作任务
task = {
    "description": "从CSV文件中读取销售数据,过滤2025年Q4的数据,"
                   "生成柱状图保存为PNG,然后发送邮件给团队",
    "required_tools": [
        "filesystem.read_file",      # 读取CSV
        "data_processing.filter",    # 过滤数据
        "data_processing.aggregate", # 聚合统计
        "chart.bar_chart",           # 生成图表
        "filesystem.write_file",     # 保存PNG
        "email.send"                 # 发送邮件
    ],
    "tool_chain_depth": 6,  # 6步工具链
    "success_criteria": [
        "数据过滤条件正确",
        "图表包含正确的数据列",
        "邮件发送给正确的收件人"
    ]
}

# 评测结果分布(近似)
results = {
    "GPT-4.1": {"file_ops": 82, "code_exec": 85, "data": 78, "network": 75, "db": 52, "image": 65, "text": 88, "sys": 45, "git": 70, "comm": 72},
    "Claude Sonnet 4.6": {"file_ops": 80, "code_exec": 83, "data": 80, "network": 73, "db": 55, "image": 62, "text": 86, "sys": 48, "git": 72, "comm": 75},
    "Gemini 2.5 Pro": {"file_ops": 78, "code_exec": 80, "data": 75, "network": 70, "db": 48, "image": 68, "text": 82, "sys": 42, "git": 65, "comm": 68},
}
训练营变现评估:Toolathlon的十类工具评估框架非常适合开发为"AI Agent工具使用全能训练营",每类工具一个模块,10个模块对应10次课程。定价1,999-3,999元/人,目标是企业AI开发团队。
IBM Research发布的NESTful基准聚焦于一个被严重忽视但极其关键的能力——嵌套API调用(Nested API Calling)。所谓嵌套调用,是指一个函数调用的输出直接作为另一个函数调用的输入参数。
在真实业务中,工具使用几乎从来不是单步的:
# 典型嵌套调用链
step1 = get_user_id(email="[email protected]")        # 返回 user_id
step2 = get_order_history(user_id=step1.user_id)      # 需要step1的结果
step3 = get_product_details(product_id=step2[0].product_id)  # 需要step2的结果
step4 = calculate_discount(product_id=step3.id, user_tier=step1.tier)  # 需要step1和step3的结果
NESTful包含1,800+可执行的嵌套序列,所有函数调用都是真实可运行的。评测结果显示: - 在单步调用中表现90%+准确率的模型,在3层嵌套调用中准确率下降到55-65% - 在5层以上嵌套中,几乎所有模型的准确率都低于40% - 参数传递错误是最常见的失败模式——模型在将上一步的输出正确映射到下一步输入参数时频繁出错
嵌套调用困难的根本原因在于: 1. 中间结果管理:模型需要在上下文中保持多个中间结果,并在正确的时机引用 2. 类型推导:上一步输出的类型需要与下一步输入的类型匹配,模型经常忽略类型约束 3. 动态依赖:某些嵌套调用需要根据中间结果的条件判断来决定下一步调用哪个函数
变现路径:嵌套调用能力是RPA(机器人流程自动化)升级为AI Agent的关键瓶颈。针对这一痛点,可以开发"嵌套调用测试框架"产品,帮助企业评估其AI Agent在复杂工作流中的可靠性。
2026年最引人注目的发现不是某个模型在某项评测中获得了多高的分数,而是实验室Benchmark与生产环境之间的巨大鸿沟。
多个独立研究和行业报告一致揭示了这个鸿沟: - MIT研究报告指出:95%的AI Agent试点项目最终失败 - Gartner预测:40%的Agentic AI项目将被取消 - Composio的2025 AI Agent报告详细分析了失败原因 - APEX-Agents基准显示:AI Agent在专业任务中的失败率高达75%
Benchmark得分 (实验室环境)        →    生产环境实际表现
─────────────────────────────────────────────────────
BFCL v4 总分: 85%                →    真实函数调用成功率: ~55%
τ²-bench: 67% (最佳)            →    真实客服场景: ~40%
Toolathlon: 70% (平均)           →    多工具协作: ~35%
MCP-Atlas: 60% (平均)            →    MCP生产集成: ~30%
| 失败类别 | 占比 | 具体表现 |
|---|---|---|
| 工具选择错误 | 28% | 从候选工具中选错函数,或调用了不存在的工具 |
| 参数构建失败 | 25% | 参数类型错误、缺失必填参数、传入了幻觉值 |
| 上下文丢失 | 22% | 多轮交互后丢失早期工具调用结果,导致后续调用出错 |
| 错误恢复失败 | 15% | 工具调用出错后无法自我修复,陷入循环或直接放弃 |
| 权限/安全问题 | 10% | 调用了无权限的工具或执行了危险操作 |
面对工具使用的复杂性,行业正在通过标准化协议来降低集成难度:
MCP(Model Context Protocol)由Anthropic发起,现已移交Linux Foundation治理,2026年路线图聚焦于: - Transport Scalability(传输层可扩展性) - Agent-to-Agent通信增强 - 治理成熟度提升 - 成为了AI Agent连接工具的事实标准
A2A(Agent-to-Agent Protocol)由Google于2025年4月发布,聚焦于: - 跨框架Agent互操作性 - Agent之间的发现和通信 - 与MCP互补而非竞争的定位
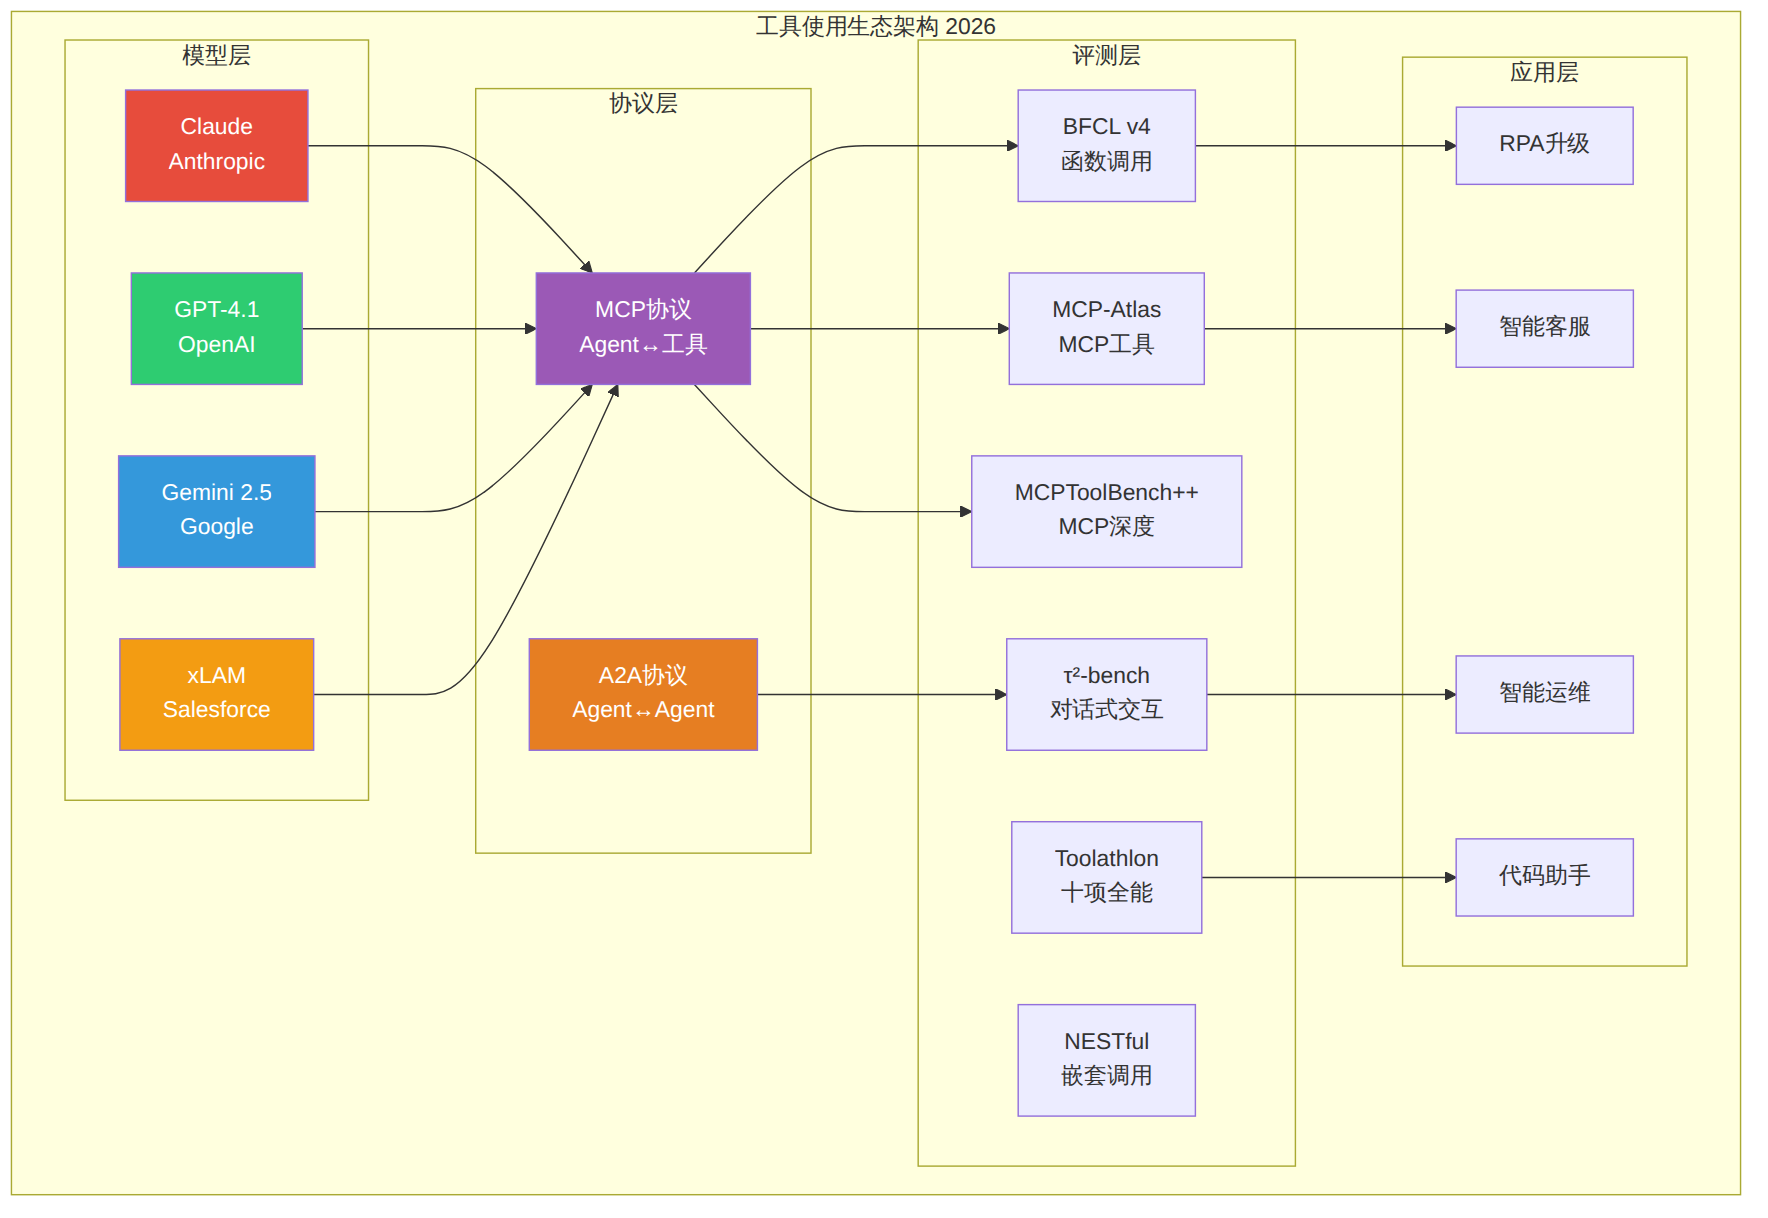
图表 3
在通用LLM争夺工具使用王冠的同时,Salesforce Research走了一条不同的路——专门为工具调用训练的模型。xLAM(Large Action Models)家族就是这一思路的产物。
xLAM的核心洞察是:工具调用不需要LLM的全部通用能力,它需要的是高度精确的函数选择和参数构建。因此,xLAM通过以下方式优化:
xLAM在NAACL 2025的论文中展示了令人印象深刻的结果: - 在函数调用准确性上,xLAM-7b在部分场景中接近GPT-4级别的表现 - 在工具选择准确率上,经过专门训练的7B模型超过了未经工具调用优化的70B通用模型 - xLAM的优势在工具数量较多的场景中更加明显——它更擅长从大量候选工具中精准选择
xLAM的成功证明了一个重要的商业洞察:工具调用可能是第一个值得用专用模型来解决的NLP任务。这为以下商业模式打开了空间: - 企业级工具调用微调服务:基于企业的私有API集合,定制训练专用的工具调用模型 - 轻量级边缘部署:7B参数的xLAM可以在消费级GPU上运行,适合对延迟敏感的本地Agent - 工具调用API网关:将xLAM部署为中间件,为通用LLM提供精准的工具调用代理
基于以上七大基准的综合分析,针对不同应用场景给出具体推荐:
| 应用场景 | 推荐基础模型 | 推荐评测基准 | 关键优化方向 | 预期成功率 |
|---|---|---|---|---|
| 客服自动化 | Claude Sonnet 4.6 | τ²-bench | 多轮对话+工具联调 | 55-65% |
| RPA流程自动化 | GPT-4.1 + xLAM | Toolathlon + NESTful | 嵌套调用链优化 | 45-55% |
| 开发助手 | Claude Opus 4.6 | BFCL v4 | 代码生成+工具调用联合 | 65-75% |
| 数据分析Agent | Gemini 2.5 Pro | MCP-Atlas | 多工具协同 | 50-60% |
| 运维自动化 | Claude Sonnet 4.6 | MCPToolBench++ | 错误恢复+重试机制 | 40-50% |
| MCP工具集成 | Claude系列 | MCP-Atlas | MCP协议深度优化 | 55-65% |
| 技术选型 | 适用团队 | 优势 | 风险 |
|---|---|---|---|
| OpenAI Agents SDK | 快速原型团队 | 工具调用成熟、文档完善、生态最大 | 供应商锁定、成本高 |
| MCP + Claude | 企业级Agent | 协议标准化、工具生态丰富、安全合规 | MCP仍在快速演进中 |
| xLAM + LangChain | 本地化部署团队 | 开源可控、轻量部署、成本低 | 需自行维护工具链 |
| Google A2A + Gemini | 跨Agent协作 | 多Agent互操作性强 | A2A协议尚在早期 |
2026年的AI Agent工具使用能力评测揭示了一个清晰的演进路径:
当前状态:Agent在简单的单步函数调用上已经接近实用水平(85%+),但在复杂的多步编排、嵌套调用和对话式工具交互上仍有巨大提升空间。生产环境中的37%性能鸿沟是当前最大的挑战。
短期趋势(2026下半年):随着MCP协议的成熟和更多专用工具调用模型的涌现,多工具编排的成功率有望从当前的45-55%提升到60-70%。A2A协议将开始解决Agent之间的互操作性问题。
长期方向(2027):工具使用能力将从"函数调用"进化为"API编排",Agent将能够自主发现、学习、组合新工具,而不仅限于预定义的工具集。NESTful揭示的嵌套调用问题将通过更好的中间结果管理机制得到根本性改善。
对于从业者而言,现在是深入投入Agent工具使用能力的最佳时机——不是因为技术已经成熟,恰恰是因为它还不够成熟,而这个问题又是Agent能否真正落地的关键瓶颈。谁能率先解决这37%的性能鸿沟,谁就能在AI Agent的商业化浪潮中占据先机。
[!tip] 51学通信知识星球 星主:爱卫生(微信:gprshome201101)——公众号「51学通信」创办者,19 年通信行业运维与讲师经验,著有《GPRS网络信令实例详解》《EPC原理与实践》《5G核心网原理与实践》三本纸质书(各大电商平台有售)。 星球定位:深耕 5G 核心网、IMS、NFV/AI、云原生等 ICT 领域,主打运维岗位与信令分析。 当前规模:5200 篇主题 / 990 个回答,198 元/年。 加入福利:加入星球后请加爱卫生微信,拉您进知识星球年度陪伴与答疑群——不限量回复您的各种问题,另有群内分享。 AI 加持:51学通信知识星球已作为 skill 接入 WorkBuddy,使用 deepseek-4-flash 在海量星球帖子中精准找贴、找视频、找 FAQ 和案例,做总结、找文档和 PPT 等场景全覆盖。
